ERPの受注入力をAIに任せる。注文の1行から商品を特定する精度を実測してみた
はじめに
FAXやメールで届いた注文を、担当者が1行ずつ販売管理システムに入力していませんか。届いた紙やPDFを見ながら、社内の商品コードを思い出して打ち込む作業です。その入力をAIに任せられないか、と考えたことはないでしょうか。
OCRの精度が上がれば解決する、と説明されることがあります。しかし文字にした時点で手に入るのは文字列だけです。たとえば「純米900 8c」という1行を読み取っても、社内の259件の商品マスターのどれを指すのか、何本になるのかは決まっていません。この最後の1歩を決めるところが、いまも人の担当として残っています。
この記事では、その最後の1歩だけを取り出して、どこまでの精度が出るかを実際に測りました。 商品マスターから候補を8件に絞り、そのなかからLLMに1件を選ばせる形です。結果を先に書きます。候補の絞り方を3通り比べたところ、商品も本数も合っていた割合は48.3%から88.3%まで変わりました。同じLLM、同じ指示文、同じ判定のままで、変えたのは候補の作り方だけです。この値は、検証用に作った架空データ120行で測ったものです。この記事では、この120行を元データと呼び、3章では乱数の種を変えて作った検証用データ120行も使います。
ただし、自動で登録してよい範囲は限られます。元データで確信度90以上の行だけを自動登録にすると、誤登録は0件でしたが、自動登録できたのは120行のうち39行(32.5%)でした。この誤登録0件はデータが変われば保たれず、検証用データでは同じしきい値90でも自動登録40件のうち2件で商品を取り違えています。購買履歴にない新規品では、いちばん成績のよかった作り方でも正解率は45.0%にとどまります(元データ、検証用データとも同じ値)。どこまでが自動で、どこからが人の確認なのか。その線をデータで引くための記事です。
結果はすべて、この検証のために作った架空のデータで測った値です。実在の得意先や商品ではありません。動作の説明はすべて実機での検証に根拠を置いています(検証環境はまとめの直後に記載)。
基礎知識|AIが担うのは、注文の1行を商品マスターの1件に決める部分
文字にする段階と、自社データに確定させる段階は別
受注の入口をAIに任せる話をするとき、最初に分けておきたい段階が2つあります。
1つめは、注文書を文字にする段階です。FAXの画像、PDF、写真、電話の音声を、文字コードの列に変換します。OCRや音声認識がこれにあたり、既存の技術で実行できます。
2つめは、その文字列を自社のデータに確定させる段階です。どの得意先の、商品マスターのどの1件を、何本かを決めます。ここまで決まって初めて、ERP(販売管理システム)に取り込める受注の1行になります。
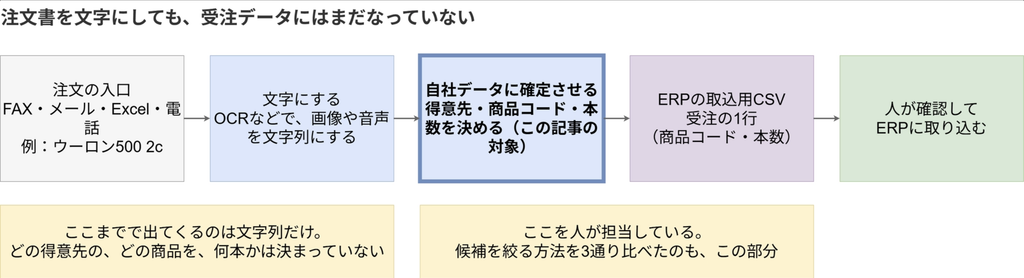
この記事が対象にするのは2つめだけです。1つめのOCRの精度は扱いません。
補足: 画像やPDFを構造化する側の手法については、【脱・OCR】Dify×VLMで、あらゆる画像・PDFを思い通りのJSONに変換する(https://nocode-sol.co.jp/blog/tech/dify-vlm-pdf-json/)もご参考ください。
入力として渡したものと、AIが出したもの
境界をはっきりさせるため、AIに渡した情報と、AIから受け取った情報を並べます。
| 区分 | 内容 |
|---|---|
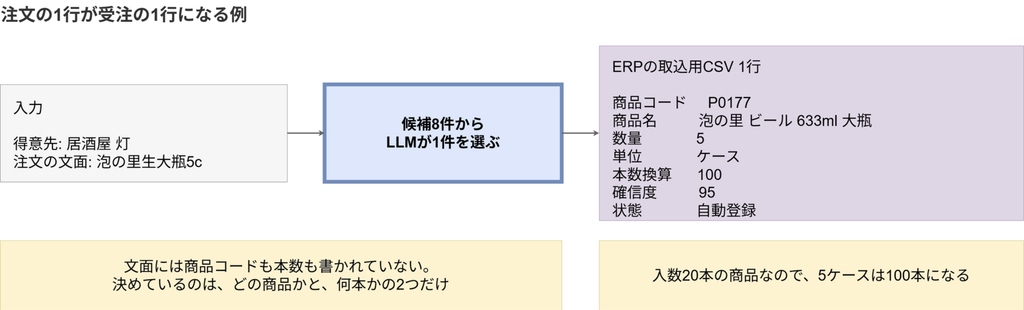
| 入力(渡したもの) | 得意先名と業態、注文の1行の文面、候補8件(商品名・入数・ケース単価。候補の作り方cではこれに得意先ごとの購入回数を追加) |
| 出力(受け取ったもの) | 候補のうち1件の番号(該当なしは0)、数量と単位、確信度、指示文v2ではさらに、何を根拠に決めたか |
扱っていないこと
受注の入口にAIを置く構想では、在庫の引き当てや発注の提案まで話が広がります。今回はそこまで扱っていません。理由は方針ではなく、データにあります。検証に使った商品マスターには在庫数の列がありません。在庫確認、発注提案、経営分析に必要な情報を、今回の検証データに含めていないため、測れないという状態です。
同じ理由で、売上の傾向分析や得意先ごとの与信も対象外です。この記事で確かめたのは、注文の1行を商品マスターの1件と本数に確定させる、その1点だけです。
この問題は entity matching の selecting にあたる
注文の1行から自社の商品を特定する作業は、学術的には entity matching(同じ実世界のものを指す記述どうしを結びつける問題)に分類されます。そのなかでも、候補の集合から1つを選ぶ形は selecting と呼ばれます。
設計の根拠にした報告が3本あります。
| 論文 | この記事での役割 |
|---|---|
| Peeters ほか(EDBT 2025) | LLMがこの種の問題で高い精度を出すこと、最適な指示文はモデルとデータの組み合わせで変わることの前提 |
| Steiner ほか(arXiv:2409.08185) | 他のドメインのデータで学習したモデルは、そのままでは精度が下がるという報告。自社のデータで測る動機 |
| Wang ほか(COLING 2025) | 二値判定より selecting 方式が優れるという報告。selecting 一本で設計した根拠 |
数字を、比較対象と指標名まで添えて写します。
Peeters らの報告では、ゼロショット(追加学習なし)のGPT-4が、EC系の3つのデータセットで従来の事前学習モデル(BERTなど)の最良ベースラインを上回り、6データセット中5つでF1が89%以上でした。
Steiner らの報告は、商品データセット WDC Products でのF1を並べています。Llama 8B はゼロショットの53.36から、構造化した説明を付けた学習で74.13まで上がります。いっぽうで、別のドメインで学習させてから転移させた場合は、ゼロショットと比べてF1が平均11.05ポイント低くなったと報告されています。自社のデータで測る必要がある、という根拠がここです。
Wang らの報告は、8つのデータセットと10種類のLLMで、二値判定(matching)、候補どうしの比較(comparing)、候補集合からの選択(selecting)の3方式を比べ、selecting 方式の優位性を確認したとしています。
今回は selecting 一本で設計し、二値判定との比較は行っていません。候補8件それぞれについてLLMを呼ぶことになり、呼び出し回数と費用が増えるためです。
実装のステップ|ERPの受注データを作る3工程と、候補の作り方の比較
完成すると何ができるか
この章のスクリプトを順に動かすと、注文の文面が並んだCSVから、ERPに取り込める形のCSVが出ます。1行ごとに商品コード、数量、単位、本数換算、確信度が入り、確信度がしきい値以上なら状態の列が自動登録に、それ未満なら要確認になります。人が見るのは要確認の行だけで済みます。
動かすのに必要なのは Node.js と、候補づくりで使う埋め込みモデルのパッケージ1つだけです。スクリプトは5本で、いずれも58行から217行の範囲です。これに、CSVを読む共通の関数を書いた23行のファイルが1つ加わります。全文を5章の付録に載せています。
3つの工程に分け、比べるのは1つめだけにする
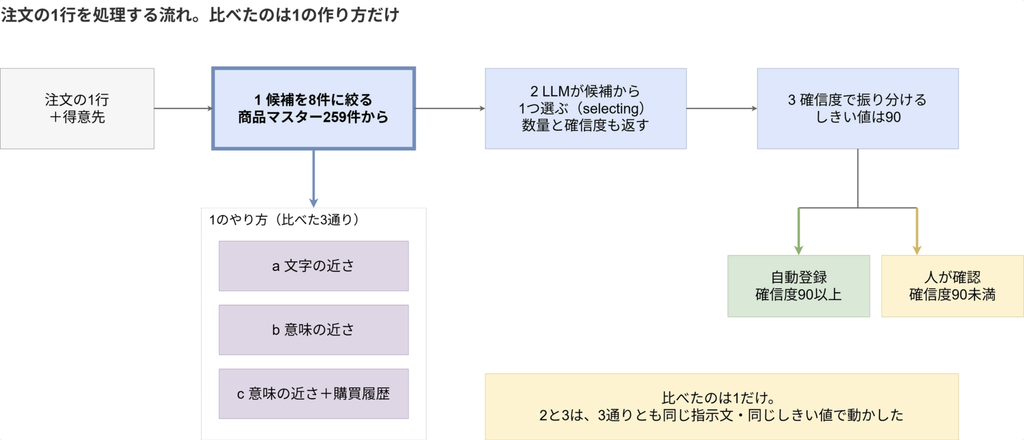
処理は3工程です。
- 商品マスター259件から、候補を8件に絞る
- LLMが候補から1件を選び、数量と確信度を返す
- 確信度で、自動登録と人の確認に振り分ける
このうち2と3は3通りとも完全に同じものを使い、比べるのは1つめの絞り方だけにしました。指示文が同じ、しきい値が同じ、モデルが同じであれば、出てきた差は候補の作り方の差だと言えるためです。しきい値90は、結果を見る前に決めて固定しました。
候補の作り方を3通り用意する
| 記号 | 絞り方 | 実装 |
|---|---|---|
| a | 文字の近さ | 商品名と商品名カナの文字n-gram(2文字と3文字)によるTF-IDF類似度で上位8件 |
| b | 意味の近さ | 多言語の埋め込みモデル multilingual-e5-small によるコサイン類似度で上位8件 |
| c | 意味の近さ+購買履歴 | その得意先が過去に買った商品から、意味の近い順に4件。残り4件を全商品から意味の近い順に埋める |
補足: 候補を作るスクリプトも、選ばせるスクリプトも、正解のファイル
truth.csvを読みません。実際の運用では正解が手元にないため、同じ条件で動かしています。
検証に使った架空データ
実在の受注データは使えないため、飲食料品卸を想定した架空データを作りました。乱数の種を固定しているので、同じコマンドを実行すれば同じデータが再現できます。
| 項目 | 内容 |
|---|---|
| 商品マスター | 259件(水・茶・清涼飲料・ビール・日本酒焼酎・調味料など11分類。ブランド名はすべて架空) |
| 得意先 | 10件(居酒屋、ラーメン店、カフェ、ホテル、社員食堂、焼肉店、弁当店、スポーツクラブ、寿司店、ダイニング) |
| 購買履歴 | 直近半年に12回の注文があった想定で、得意先ごとに常備商品の購入回数を持たせたもの |
| 注文の行 | 120行(得意先ごとに、購買履歴にある既存品10行と、購買履歴にない新規品2行) |
注文の文面には、実務で見かける書き方のばらつきを入れてあります。ブランド名を書かない行、規格を書かない行、いつもの、と書く行、半角カナの行、全角数字の行、1文字抜けた誤記の行です。
ここは注意して読んでいただきたい点です。 どの癖がどれくらいの割合で出るかは、実データから求めた値ではなく、得意先の書き方の癖ごとに仮に置いた値です。実データでは得意先ごとにこの割合が違うため、ここで出た正解率がそのまま実務の数字になるとは考えないでください。
補足: 架空データを使う場合の評価の組み立て方については、AI時代の構造化データの置き方|情シスのためのガバナンスとPoC評価(https://nocode-sol.co.jp/blog/tech/ai-structured-data-governance-poc/)もご参考ください。
LLMに渡している指示文
実際にLLMへ渡している指示文です。--show-prompt を付けると、LLMを呼ばずに1件目の指示文だけを表示できます。
$ node select.mjs 確認用 --only c --prompt v1 --show-prompt
実行名 確認用(データ data / 指示文 v1 / 対象 c): 120件を処理します(済み 0件)

--- c / L001 に渡す指示文(v1)---

【得意先】居酒屋 灯(居酒屋)
【注文の1行】純米900 8c

【候補】
1. P0027 | 高原園 麦茶 500ml PET | 入数24本 | ケース単価2640円 | この得意先の直近半年の購入回数: 4回
2. P0197 | 氷雫 ライム 500ml 缶 | 入数24本 | ケース単価5400円 | この得意先の直近半年の購入回数: 4回
(候補3〜8は省略。全文は5章の付録の buildPromptV1 を参照)

【読み方のルール】
- ケース、ケース、ケ、c、cs は1ケース(その商品の入数ぶん)を表す。バラ、本 は1本を表す。
- 候補の中に該当する商品が無いときは、selected を 0 にする。
- 注文の文面と購入回数の両方を見ても複数の候補を区別できないときは、confidence を 50 以下にする。
- 文面と購入回数から1つに絞れ、ほかの候補と取り違える余地がないときだけ、confidence を 90 以上にする。
- 購入回数は参考情報である。文面がほかの商品をはっきり指しているときは、購入回数より文面を優先する。

【出力】次のJSONだけを出力する。
{"selected": 候補の番号(0は該当なし), "quantity": 数量(整数), "unit": "ケース" または "本", "confidence": 0から100の整数, "reason": "20字以内の理由"}
候補は商品コード順に並べています。検索の順位をそのまま出すと、LLMが上位のものを選びやすくなり、候補の作り方の差が見えにくくなるためです。
結果1: 候補の作り方で、正解率は48.3%から88.3%まで変わった
元データ120行での結果です。3通りをそれぞれ120行ぶん実行し、合計360件の返答を集計しました。形が崩れて読めなかった返答は0件です。
| 候補の作り方 | 候補8件に正解が入った | 商品が合っていた | 商品も本数も合っていた |
|---|---|---|---|
| a 文字の近さ | 94.2%(113/120) | 51.7%(62/120) | 50.8%(61/120) |
| b 意味の近さ | 92.5%(111/120) | 49.2%(59/120) | 48.3%(58/120) |
| c 意味の近さ+購買履歴 | 99.2%(119/120) | 89.2%(107/120) | 88.3%(106/120) |
補足: 商品も本数も合っていた、が受注の1行としてそのまま登録できる状態です。以降はこの列を正解率と呼びます。
読み取れることが2つあります。
1つめは、候補に正解が入る割合と、最終的な正解率が別だということです。aは候補8件のなかに94.2%の割合で正解を入れていますが、そこから1件を選ばせると50.8%まで落ちます。候補を用意できることと、選び切れることは別の話になります。
2つめは、購買履歴を候補に足したcだけが、その落ち込みを抑えていることです。cとaの差は37.5ポイント(88.3から50.8を引いた値)です。この差を生んでいるのは、候補一覧に購入回数の列が付くことと、その得意先が過去に買った商品が候補に必ず4件入ることの2つです。
しきい値を動かすと、自動登録の件数と誤登録の件数が入れ替わる
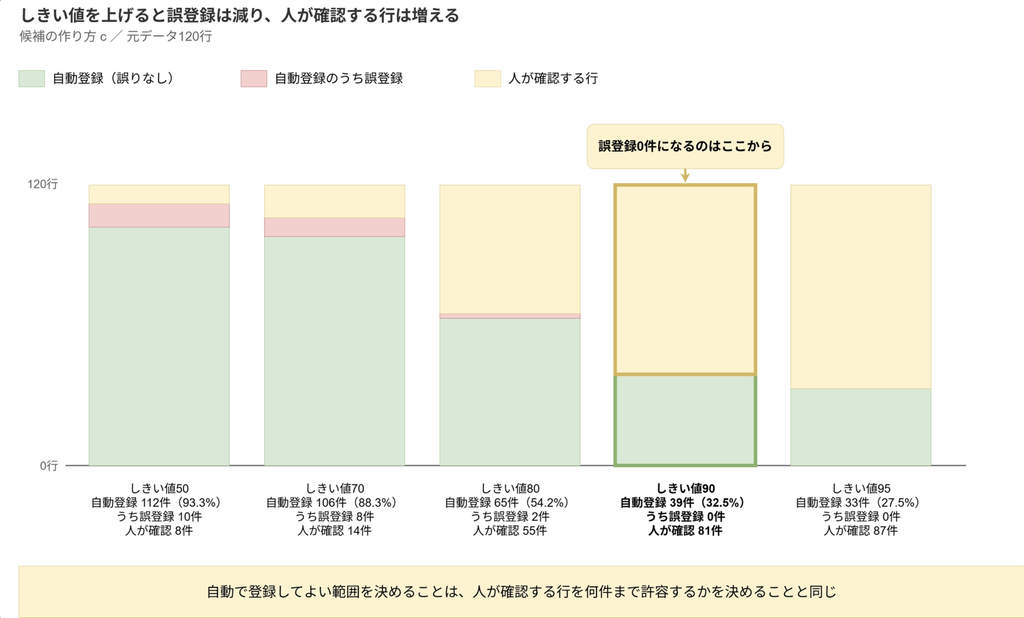
確信度のしきい値ごとに、自動登録にできた件数と、そのうち誤っていた件数を並べます。cの元データ120行での結果です。
| しきい値 | 自動登録 | うち誤登録 | 誤登録の割合 | 人が確認する行 |
|---|---|---|---|---|
| 50 | 112件(93.3%) | 10件 | 8.9% | 8件 |
| 70 | 106件(88.3%) | 8件 | 7.5% | 14件 |
| 80 | 65件(54.2%) | 2件 | 3.1% | 55件 |
| 90 | 39件(32.5%) | 0件 | 0.0% | 81件 |
| 95 | 33件(27.5%) | 0件 | 0.0% | 87件 |
しきい値90で誤登録が0件になりますが、自動登録できるのは39件(32.5%)です。しきい値70なら106件(88.3%)を自動登録できますが、そのうち8件(7.5%)が誤っています。
ここで言えるのは、誤登録を0件に保てる範囲が存在することと、その範囲が120行のうち39行だったことです。 受注入力が自動化できた、とは書けません。書けるのは、確信度90以上の行に限れば自動登録して誤りが出なかった、までです。
参考までに、同じしきい値90で、aは29件(24.2%)を自動登録して誤登録0件、bは30件(25.0%)を自動登録して誤登録3件(10.0%)でした。自動登録の件数だけを見るとaとbはcに近く見えますが、cは同じ誤登録0件のまま39件まで伸ばしています。
補足: 確信度で人の確認に回す設計そのものについては、Human-in-the-Loopの概念をDifyに落とし込み、AIの暴走を防ぐ安全設計を構築する(https://nocode-sol.co.jp/blog/tech/dify-human-in-the-loop/)もご参考ください。
行の種類ごとに見ると、新規品だけが取り残される
しきい値90での結果を、行の種類ごとに分けます。表の各セルは、正解率 / 自動登録件数 / 誤登録件数の順です。元データ120行での結果です。
| 行の種類 | 行数 | a 文字の近さ | b 意味の近さ | c 意味の近さ+購買履歴 |
|---|---|---|---|---|
| 既存品(購買履歴にある) | 100 | 53.0% / 26 / 0 | 50.0% / 26 / 3 | 97.0% / 34 / 0 |
| 新規品(購買履歴にない) | 20 | 40.0% / 3 / 0 | 40.0% / 4 / 0 | 45.0% / 5 / 0 |
| ブランドも規格も書いてない行 | 25 | 16.0% / 0 / 0 | 4.0% / 0 / 0 | 76.0% / 2 / 0 |
| ブランドか規格のどちらかは書いてある行 | 95 | 60.0% / 29 / 0 | 60.0% / 30 / 3 | 91.6% / 37 / 0 |
既存品ではcが97.0%まで上がり、ブランドも規格も書いてない行でも76.0%に届いています。文面の情報が足りなくても、購買履歴が不足を埋めているためです。
いっぽう新規品20行では、cでも45.0%にとどまります。aの40.0%、bの40.0%と比べて、ほとんど変わっていません。購買履歴に無い商品に対しては、購買履歴を足す手法は成立しません。 新商品の初回注文、季節商品、臨時の発注は、この方式の対象外として人が入力する前提で設計することになります。
ERPの取込用CSVにする
選ばれた結果を、既存ERPに取り込める形のCSVに変換します。このスクリプトも正解のファイルを読みません。元データに指示文v1で答えさせた結果を、既定のしきい値90で変換した出力です。
$ node to_csv.mjs run2 --variant c
results/run2_erp.csv を書き出しました(c / しきい値90)
  自動登録 39件(32.5%) / 要確認 81件(うち返答を読めず 0件)

--- 先頭3行 ---
行ID,得意先コード,得意先名,注文の文面,商品コード,商品名,数量,単位,本数換算,確信度,状態
L001,C01,居酒屋 灯,純米900 8c,P0215,雪蔵 純米酒 900ml 瓶,8,ケース,96,75,要確認
L002,C01,居酒屋 灯,本醸1800ml 6c,P0224,薩摩の郷 本醸造 1.8L 瓶,6,ケース,36,70,要確認
L003,C01,居酒屋 灯,麦の穂ノンアル 2c,P0155,麦の穂 ノンアルビール 350ml 缶,2,ケース,48,88,要確認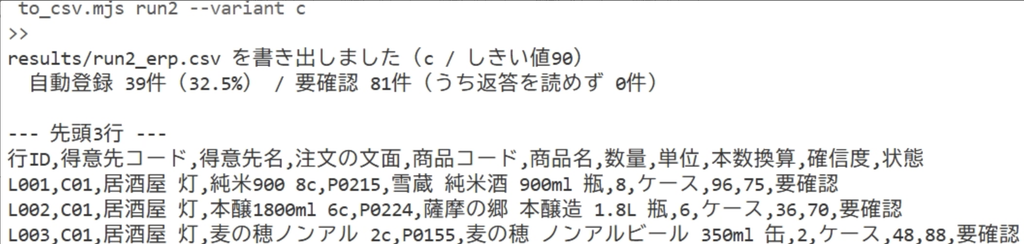
先頭の3行はいずれも確信度が90に届かず、要確認に回っています。自動登録に回ったのは、次のような行です。
L008,C01,居酒屋 灯,泡の里生大瓶5c,P0177,泡の里 ビール 633ml 大瓶,5,ケース,100,95,自動登録
L026,C03,カフェ ソレイユ,モーニング ミルコーヒー 500ml 6ケース,P0107,モーニング ミルクコーヒー 500ml PET,6,ケース,144,95,自動登録
L028,C03,カフェ ソレイユ,みずの森天然水500ml 1ケース,P0001,みずの森 天然水 500ml PET,1,ケース,24,95,自動登録
状態の列が自動登録と要確認に分かれ、人が見るのは要確認の81行だけになります。しきい値は --threshold で変えられるので、運用しながら動かして決められます。既存のERPを置き換える必要はなく、取込用CSVを作る工程が1つ増えるだけの構成です。
元データでは、この39件はすべて正しく登録できていました。ただし、誤登録0件という値は、データが変われば保たれません。 3章で使う検証用データでは、同じしきい値90でも自動登録40件のうち2件で商品を取り違えています。
補足: 得意先ごとの商品コードをEDIで受け取っている場合の連携については、【EDI 2024年問題】製造業のEDIツール完全ガイド|選定5観点とAI連携まで情シス向けに徹底解説(https://nocode-sol.co.jp/blog/tech/edi-tools-manufacturing-guide/)もご参考ください。
応用・発展|指示文の書き直しと、AIが何を根拠に決めたかの自己申告
誤った14件を1件ずつ確認した
候補の作り方cで、元データ120行のうち誤っていたのは14件でした。1件ずつ中身を確認したところ、内訳は新規品11件、既存品3件です。14件のうち11件が、購買履歴に無い商品でした。 LLMが返した理由の文にも、購入回数が最多だから、と書かれているものがありました。
残る既存品3件は、指示文の書き方で直せると判断しました。
L046「麦の穂ビール6336ケース」
  商品は正解だが、633(規格)と6(数量)を分けられず本数を誤った

L012「いつもの麦8cs」
  正解は麦茶だが、ブランド名「麦の穂」のノンアルビールを選んだ

L099「ヤマ正 本みりん1ケース」
  理由に「購入実績が最多」と書きながら、購入0回の方を選んだ
3件とも、文面の読み取り方の規則を書いていなかったために起きています。
指示文v2で直した5点
v1の誤りを見たうえで、指示文を書き直しました。直したのは5点です。
| 直した点 | 内容 |
|---|---|
| 1. 考える順序を指定 | 文面を商品の部分と数量の部分に分ける、語を照合する、それでも残るときだけ購入回数を使う、の順に固定した |
| 2. 規格と数量を分ける規則 | 185、350、500、633、1.8L などは規格であり数量ではない、数量はケースや本の直前の数字である、と明示した |
| 3. ブランド名と商品名の区別 | 麦は商品名の麦茶を指すこともブランド名の麦の穂を指すこともある、判断できないときは確信度を下げる、と明示した |
| 4. 確信度を4段階に変更 | 95、90、70、40 の4つだけを使わせ、それぞれの条件を文で定義した |
| 5. 根拠の欄を追加 | decided_by として、文面 / 購入回数 / 推測 のいずれかを返させるようにした |
5点目が3章の山場につながります。何を見て決めたのかをLLM自身に申告させる欄です。
なぜ、別の120行で測り直したのか
ここが結果の読み方を左右します。
v2は、v1が誤った14件を見てから書いた指示文です。 同じ120行で測れば、直した行がそのまま正解に変わるので、実力より良い数字が出ます。そこで、乱数の種を変えて別の120行を作り、調整に使っていないデータで比べ直しました。以降、元の120行を元データ、種を変えた120行を検証用データと呼びます。
2つのデータの難易度が近いことは、次の値で確認しています。
| 指標 | 元データ | 検証用データ |
|---|---|---|
| 候補8件に正解が入った割合(c) | 99.2% | 98.3% |
| 新規品の行数 | 20行 | 20行 |
| ブランドも規格も書いてない行数 | 25行 | 25行 |
| 指示文v1での正解率(c) | 88.3% | 87.5% |
同じ指示文v1を両方のデータで動かすと、正解率は88.3%と87.5%でした。難易度が大きく違うデータではないと判断しています。
結果2: v1とv2の差は120件中2件にとどまった
検証用データ120行での、指示文v1と指示文v2の比較です。候補の作り方はcに固定しています。2回の実行は、指示文を切り替えただけで、ほかの条件はすべて同じです。
| 指標 | v1 | v2 |
|---|---|---|
| 商品も本数も合っていた | 87.5%(105/120) | 89.2%(107/120) |
| しきい値70での自動登録 | 109件(90.8%) | 111件(92.5%) |
| しきい値70での誤登録 | 9件(8.3%) | 7件(6.3%) |
| しきい値90での自動登録 | 43件(35.8%) | 40件(33.3%) |
| しきい値95での誤登録の割合 | 5.6% | 2.9% |
指示文の修正がそのまま結果に出た行もあります。
L001「グレフル3508c」(正解は8ケース = 192本)
  v1: 3508ケース(84,192本) → 誤り
  v2: 8ケース(192本)       → 正解
規格の数字と数量の数字を分ける規則を書いたことで、3508を1つの数量として読まなくなりました。
ただし、この表の数字を精度の向上として読むことはできません。 正解率の差は87.5%から89.2%、件数にすると120件中2件です。v2で正しくなった行が4件(L001、L042、L066、L090)、逆に誤るようになった行が2件(L013、L094)あり、差し引きで2件です。実行は各1回だけで、同じ条件での再実行はしていません。2件の差が指示文の改善によるものか、1回の実行のばらつきの範囲なのかは、この結果からは区別できません。
ばらつきは確信度にも出ます。同じ指示文v1・同じ候補でL001をもう1回流すと、選ばれた商品は同じでしたが、確信度は75から80に動きました。この2つはどちらもしきい値90未満なので振り分けは変わりませんが、90の前後にある行では、同じ注文が実行のたびに自動登録と要確認を行き来しえます。しきい値を決めるときは、1回の結果ではなく、同じデータを数回流したときの確信度の散らばりまで見てください。
言えるのは、狙って直した行が実際に直ったことと、全体の正解率はほとんど動かなかったことの2つです。
結果3: AIが推測で決めたと答えた行は、3分の1しか合っていない
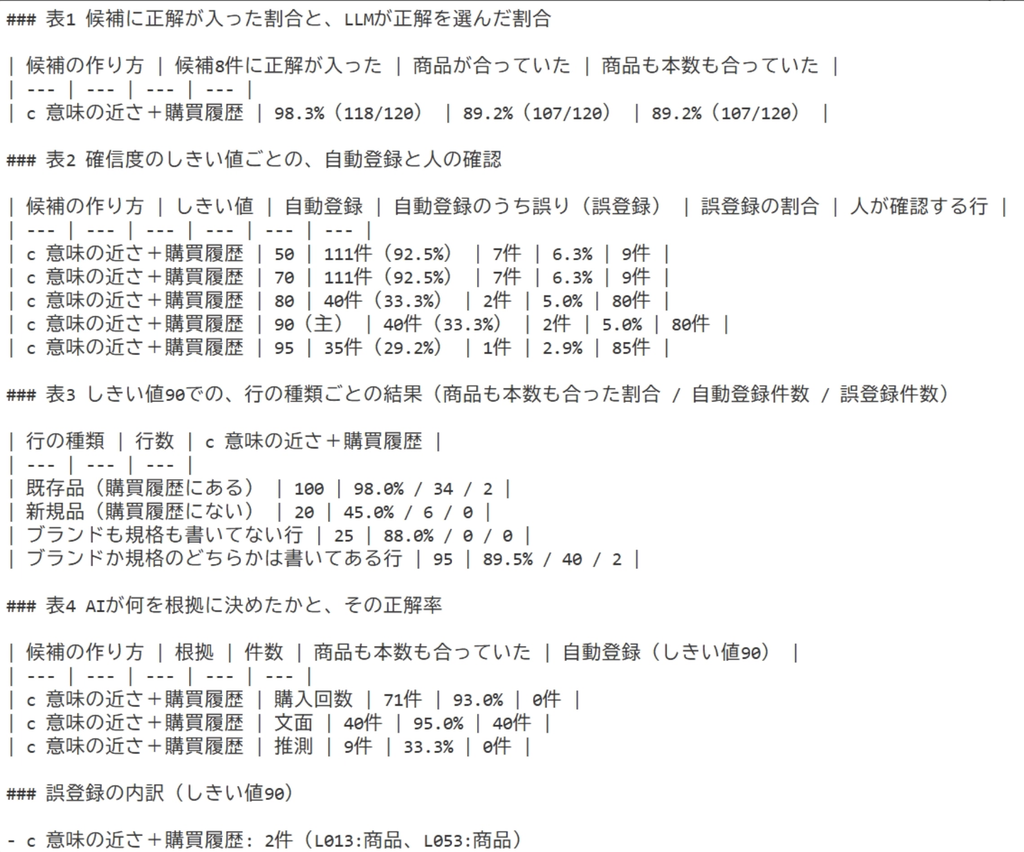
v2で追加した decided_by の欄を集計します。検証用データ120行での結果です。
| 根拠 | 件数 | 正解率 | しきい値90での自動登録 |
|---|---|---|---|
| 文面 | 40件 | 95.0% | 40件 |
| 購入回数 | 71件 | 93.0% | 0件 |
| 推測 | 9件 | 33.3% | 0件 |
文面で決めた40件は95.0%、購入回数で決めた71件は93.0%の正解率です。これに対し、推測で決めたと自己申告した9件は33.3%、実際に合っていたのは3件だけでした。
自己申告が、人に回す行を選ぶ材料になります。 この9件は確信度も40が付いており、しきい値90でも70でも自動登録には入りません。
しきい値70で運用すると、文面と購入回数で決めた111件(92.5%)が自動登録に回り、推測の9件が人の確認に回ります。そのときの誤登録は7件(6.3%)です。確信度と根拠の2つが、同じ9件を人の側に寄せる形になっています。
誤登録を機械的に検出することはできなかった
選ばれた結果のなかから、誤っているものを後から見つけられないかを試しました。対象は、検証用データ120行を指示文v2で処理し、しきい値70で自動登録に回った111件です。そのうち7件が誤っています。正解を持たない状態でも使える規則を2つ立て、この111件に当てました。
| 規則 | 人に回る件数 | そのうち本当に誤り | 見逃した誤り |
|---|---|---|---|
| 本数が500本超の行を人に回す | 0件 | 0件 | 7件 |
| 購入回数0回の商品を選んだ行を人に回す | 9件 | 3件 | 4件 |
どちらの規則でも、誤りを取り切れませんでした。誤っている7件のうち4件は、その得意先が直近半年に6回から9回買っている商品です。数量も不自然ではなく、商品名も文面と矛盾していません。ブランド名が書かれていない注文に対して、別のブランドの同じ商品を選んだ誤りだからです。人が見ても、正解を知らなければ区別できません。
残る3件は購入回数0回の商品を選んでいるので、2つめの規則で拾えます。ただしこの規則は111件のうち9件を人に回し、そのうち6件は正しく選べていた行です。購買履歴にない商品を初めて注文する行は実際にあるため、購入回数0回を理由に人へ回すと、新規品の注文をまとめて止めることになります。
この記事では、誤登録を検出できる、とは書きません。 実測して、正解を持たない状態では検出できないことを確認しています。書けるのは、確信度で振り分けたあと、数量の桁など別の観点で確認を重ねられる、までです。
費用と、外部にデータを出せない場合
3回の実行にかかった費用です。表示された値であり、請求額ではありません。
| 実行 | データ | 内容 | 件数 | 費用 |
|---|---|---|---|---|
| run2 | 元データ | 候補の作り方 a / b / c の比較 | 360件 | 6.08ドル |
| d2_v1 | 検証用データ | 指示文v1(cのみ) | 120件 | 2.04ドル |
| d2_v2 | 検証用データ | 指示文v2(cのみ) | 120件 | 2.22ドル |
3回を合わせて10.34ドル相当です。使用したモデルは Claude Haiku 4.5 の1種類のみで、ほかのモデルとの比較は行っていません。実行はいずれも1回だけで、同条件での再実行はしていません。なお1件あたりは約0.017ドルですが、この大半は出力の思考トークンです。1件を抜き出して内訳を見ると、入力3,677トークンに対して出力は1,581トークンで、そのうち1,527が思考トークンでした。取り出して使うJSONは50トークンほどです。思考の有無や、Claude Code を介さずAPIを直接呼ぶかどうかで、1件あたりの費用は大きく変わります。自社の件数で見積もるときは、この記事の数字をそのまま掛けるのではなく、同じ条件で数件だけ流して1件あたりを測り直してください。
なお、注文データを外部のサービスに送れない事情がある場合は、手元で動かすローカルLLMで試す方法もありますが、今回の検証は通常のLLMで行っており、ローカルLLMでの精度は測っていません。
まとめと結論
架空データ120行の検証から言えることを並べます。
- 候補の作り方で正解率が大きく変わります。 文字の近さで絞ると50.8%、意味の近さで絞ると48.3%、意味の近さに購買履歴を足すと88.3%でした(元データ120行、指示文v1)。LLMも指示文もしきい値も同じにしたうえでの差です
- 誤登録を0件に保てる範囲があります。 確信度90以上の行に限れば、自動登録39件(32.5%)で誤登録0件でした(元データ120行、候補の作り方c)。しきい値を70に下げると自動登録は106件(88.3%)に増え、誤登録が8件(7.5%)出ます
- 購買履歴に無い商品は、この方式では決め切れません。 新規品20行での正解率は、いちばん成績のよかったcでも45.0%です。新商品や臨時の発注は人が入力する前提で設計することになります
- AI自身の自己申告が、人に回す行を選ぶ材料になります。 推測で決めたと申告した9件の正解率は33.3%で、文面で決めた40件の95.0%、購入回数で決めた71件の93.0%とはっきり分かれました(検証用データ120行、指示文v2)
同じくらい、言えないことも書いておきます。
- AIで受注入力が自動化できた、とは言えません。 言えるのは、元データ120行では、確信度90以上の行に限れば自動登録39件で誤りが出なかった、までです。残りの81行は人の確認に回っています。しかも検証用データでは、同じ確信度90以上でも自動登録40件のうち2件で商品を取り違えており、誤登録0件はデータが変われば保たれません
- 指示文の書き直しで精度が上がった、とは言えません。 正解率の差は120件中2件です。狙って直した行は直りましたが、全体としては1回の実行のばらつきと区別が付きません
- 誤登録を後から検出できる、とは言えません。 2つの規則を実測し、正解を持たない状態では取り切れないことを確認しました
- この数字がそのまま実務に当てはまるとは言えません。 架空データでの値であり、注文の文面の癖も、実データから求めた値ではなく仮に置いた確率です。得意先の書き方の分布が変われば結果も変わります
自社で確かめる場合に必要なものは多くありません。商品マスター、得意先の一覧、直近半年の購買履歴、注文の文面を数十行から百行ぶんと、それぞれの正解です。正解を人が付ける作業が残りますが、そこを用意しなければ、精度を測ることも、しきい値を決めることもできません。他社のデータで学習したモデルが自社でそのまま通用するとは限らないことは、Steiner らの報告でも示されています。
検証環境:
- Node.js v24.18.1
- 使用パッケージ:
@huggingface/transformers4.3.0(候補の作り方 b と c で使う埋め込みモデル multilingual-e5-small の実行に使用) - 使用モデル: Claude Haiku 4.5(Claude Code 2.1.226 の
claude -p経由で呼び出し)。実行は各1回のみで、同条件での再実行はしていません - Windows 11 Pro(ビルド26200)
- 検証日: 2026年9月25日
- 使用データ: 本記事用に作成した架空データ(商品マスター259件、得意先10件、注文120行)を2組。元データは乱数の種 20260919、検証用データは 20260925
付録|スクリプト全文と実行コマンド
本文で動かしたスクリプト5本と共通の関数、package.json の全文です。7点を同じフォルダに置き、npm install を実行してから使ってください。
実行の順序は次のとおりです。
# 1. 架空データを作る(元データ。data フォルダに5つのCSVが出る)
node gen_data.mjs

# 2. 検証用データを作る(乱数の種を変えて data2 フォルダに作る)
node gen_data.mjs --seed 20260925 --out data2

# 3. 候補を8件に絞る(a・b・c の3通りを一度に作る)
node candidates.mjs
node candidates.mjs --data data2

# 4. LLMに選ばせる(run2 は3通り、d2_v1 と d2_v2 は c のみ)
node select.mjs run2
node select.mjs d2_v1 --data data2 --only c --prompt v1
node select.mjs d2_v2 --data data2 --only c --prompt v2

# 5. 集計する(results フォルダに summary_*.md が出る)
node evaluate.mjs run2
node evaluate.mjs d2_v1 d2_v2 --data data2

# 6. ERPの取込用CSVにする(しきい値の既定は90。--threshold で変えられる)
node to_csv.mjs d2_v2 --data data2
package.json
{
  "name": "techblog16-order-entity-matching",
  "version": "1.0.0",
  "private": true,
  "description": "注文の1行から自社の商品マスターの1件を特定する検証(テックブログ[17])",
  "scripts": {
    "gen": "node gen_data.mjs",
    "candidates": "node candidates.mjs",
    "select": "node select.mjs",
    "evaluate": "node evaluate.mjs"
  },
  "dependencies": {
    "@huggingface/transformers": "^4.3.0"
  }
}
lib.mjs(CSVを読む共通の関数)
// lib.mjs: CSVを読む共通の関数(ダブルクォートで囲んだ項目に対応)
import fs from 'node:fs';

export function readCsv(file) {
  const rows = [];
  for (const line of fs.readFileSync(file, 'utf8').replace(/\r\n?/g, '\n').split('\n')) {
    if (!line) continue;
    const cells = [];
    let cur = '';
    let inq = false;
    for (let i = 0; i < line.length; i++) {
      const ch = line[i];
      if (inq) {
        if (ch === '"' && line[i + 1] === '"') { cur += '"'; i++; } else if (ch === '"') inq = false; else cur += ch;
      } else if (ch === '"') inq = true;
      else if (ch === ',') { cells.push(cur); cur = ''; } else cur += ch;
    }
    cells.push(cur);
    rows.push(cells);
  }
  const [head, ...body] = rows;
  return body.map((r) => Object.fromEntries(head.map((h, i) => [h, r[i]])));
}
gen_data.mjs(3-4:架空データを作る)
// gen_data.mjs: 飲食料品卸の架空データ(商品マスター・得意先・購買履歴・注文の1行)を作る。
// 乱数の種を固定してあるので、何度実行しても同じデータになる。
// 使い方: node gen_data.mjs [--seed 種] [--out フォルダ]
//   既定は --seed 20260919 --out data(最初に作ったデータと同じものが出る)
//   指示文の良し悪しを測るときは、種を変えた別のデータを作り、そちらで比べる
import fs from 'node:fs';

const argv = process.argv.slice(2);
const SEED = argv.includes('--seed') ? Number(argv[argv.indexOf('--seed') + 1]) : 20260919;
const OUT = argv.includes('--out') ? argv[argv.indexOf('--out') + 1] : 'data';

// 乱数(mulberry32)。種を固定すると毎回同じ列が出る
function rng(seed) {
  let s = seed >>> 0;
  return () => {
    s += 0x6D2B79F5;
    let t = s;
    t = Math.imul(t ^ (t >>> 15), t | 1);
    t ^= t + Math.imul(t ^ (t >>> 7), t | 61);
    return ((t ^ (t >>> 14)) >>> 0) / 4294967296;
  };
}
const R = rng(SEED);
const pick = (a) => a[Math.floor(R() * a.length)];
const chance = (p) => R() < p;
const shuffle = (a) => {
  a = [...a];
  for (let i = a.length - 1; i > 0; i--) { const j = Math.floor(R() * (i + 1)); [a[i], a[j]] = [a[j], a[i]]; }
  return a;
};

// ---- 商品の定義(ブランドはすべて架空) ----
// S(表記, 注文文面での書き方, 入数, 1本の単価, カナ表記)
const S = (label, say, pack, unit, kana) => ({ label, say, pack, unit, kana });
const P500 = ['500ml', '500', '500ML'];
const P2L = ['2L', '2リットル', '2000ml'];
const P350C = ['350缶', '350ml', '350'];
const P500C = ['500缶', '500ml', '500'];
const P1L = ['1L', '1000ml', '1リットル'];
const P18 = ['1.8L', '一升瓶', '1800ml'];
const CAT = [
  { cat: '水', brands: [['みずの森', 'ミズノモリ', ['みずの森', '森']], ['山麓の水', 'サンロクノミズ', ['山麓', 'さんろく']], ['白樺名水', 'シラカバメイスイ', ['白樺', 'しらかば']]],
    products: [['天然水', 'テンネンスイ', ['水', '天然水']], ['炭酸水', 'タンサンスイ', ['炭酸', '炭酸水']]],
    sizes: [S('500ml PET', P500, 24, 90, '500'), S('2L PET', P2L, 6, 150, '2L')] },
  { cat: '茶', brands: [['茶の里', 'チャノサト', ['茶の里', '里']], ['高原園', 'コウゲンエン', ['高原園', '高原']]],
    products: [['緑茶', 'リョクチャ', ['緑茶', 'お茶']], ['麦茶', 'ムギチャ', ['麦茶', '麦']], ['ほうじ茶', 'ホウジチャ', ['ほうじ茶', 'ほうじ']], ['ウーロン茶', 'ウーロンチャ', ['ウーロン茶', 'ウーロン']], ['ジャスミン茶', 'ジャスミンチャ', ['ジャスミン茶', 'ジャスミン']], ['玄米茶', 'ゲンマイチャ', ['玄米茶', '玄米']]],
    sizes: [S('500ml PET', P500, 24, 110, '500'), S('2L PET', P2L, 6, 180, '2L')] },
  { cat: '清涼', brands: [['サンライズ', 'サンライズ', ['サンライズ', 'サンR']], ['ブルーレイク', 'ブルーレイク', ['ブルレ', 'ブルー']]],
    products: [['コーラ', 'コーラ', ['コーラ']], ['サイダー', 'サイダー', ['サイダー', 'サイダ']], ['ジンジャーエール', 'ジンジャーエール', ['ジンジャーエール', 'ジンジャー']], ['オレンジ', 'オレンジ', ['オレンジ', 'オレ']], ['グレープ', 'グレープ', ['グレープ', 'ぶどう']], ['レモンスカッシュ', 'レモンスカッシュ', ['レモンスカッシュ', 'レモスカ']]],
    sizes: [S('350ml 缶', P350C, 24, 105, '350カン'), S('500ml PET', P500, 24, 125, '500'), S('1.5L PET', ['1.5L', '1500ml', '1.5リットル'], 8, 190, '1.5L')] },
  { cat: 'スポーツ', brands: [['アクティブ', 'アクティブ', ['アクティブ', 'アクテ']], ['ハイドロ', 'ハイドロ', ['ハイドロ', 'ハイド']]],
    products: [['スポーツドリンク', 'スポーツドリンク', ['スポーツドリンク', 'スポドリ']], ['ゼロスポーツ', 'ゼロスポーツ', ['ゼロスポーツ', 'ゼロスポ']], ['経口補水液', 'ケイコウホスイエキ', ['経口補水液', '補水液']]],
    sizes: [S('500ml PET', P500, 24, 135, '500'), S('2L PET', P2L, 6, 220, '2L')] },
  { cat: 'コーヒー', brands: [['珈琲堂', 'コーヒードウ', ['珈琲堂', '堂']], ['モーニング', 'モーニング', ['モーニング', 'モニ']]],
    products: [['ブラック無糖', 'ブラックムトウ', ['ブラック', '無糖']], ['微糖', 'ビトウ', ['微糖']], ['カフェオレ', 'カフェオレ', ['カフェオレ', 'カフェ']], ['ミルクコーヒー', 'ミルクコーヒー', ['ミルクコーヒー', 'ミルコー']]],
    sizes: [S('185g 缶', ['185缶', '185g', '缶'], 30, 95, '185カン'), S('500ml PET', P500, 24, 130, '500'), S('1L 紙パック', P1L, 6, 210, '1L')] },
  { cat: '果汁', brands: [['果樹園', 'カジュエン', ['果樹園', '果樹']], ['朝摘み', 'アサヅミ', ['朝摘み', '朝']]],
    products: [['りんご', 'リンゴ', ['りんご', 'アップル']], ['オレンジ', 'オレンジ', ['オレンジ', 'オレ']], ['ぶどう', 'ブドウ', ['ぶどう', 'グレープ']], ['トマト', 'トマト', ['トマト']], ['野菜', 'ヤサイ', ['野菜', 'ヤサイ']], ['グレープフルーツ', 'グレープフルーツ', ['グレープフルーツ', 'グレフル']]],
    sizes: [S('1L 紙パック', P1L, 6, 220, '1L'), S('190g 缶', ['190缶', '190g', '缶'], 30, 90, '190カン'), S('500ml PET', P500, 24, 140, '500')] },
  { cat: 'ビール', brands: [['麦の穂', 'ムギノホ', ['麦の穂', '穂']], ['黄金麦', 'オウゴンムギ', ['黄金麦', '黄金']], ['泡の里', 'アワノサト', ['泡の里', '泡']]],
    products: [['ビール', 'ビール', ['ビール', '生']], ['発泡酒', 'ハッポウシュ', ['発泡酒', '発泡']], ['ノンアルビール', 'ノンアルビール', ['ノンアル', 'ノンアルビール']]],
    sizes: [S('350ml 缶', P350C, 24, 230, '350カン'), S('500ml 缶', P500C, 24, 305, '500カン'), S('633ml 大瓶', ['大瓶', '633ml', '633'], 20, 340, '大瓶'), S('500ml 中瓶', ['中瓶', '500瓶', '中'], 20, 320, '中瓶'), S('10L 樽', ['10L樽', '樽', '10L'], 1, 8200, '10L樽')] },
  { cat: '酎ハイ', brands: [['氷雫', 'ヒョウテキ', ['氷雫', '雫']], ['果実ほろ', 'カジツホロ', ['ほろ', '果実ほろ']]],
    products: [['レモン', 'レモン', ['レモン', 'レモ']], ['梅', 'ウメ', ['梅', 'うめ']], ['グレープフルーツ', 'グレープフルーツ', ['グレープフルーツ', 'グレフル']], ['ライム', 'ライム', ['ライム']], ['白桃', 'ハクトウ', ['白桃', 'もも']]],
    sizes: [S('350ml 缶', P350C, 24, 170, '350カン'), S('500ml 缶', P500C, 24, 225, '500カン')] },
  { cat: 'ハイボール', brands: [['山の峰', 'ヤマノミネ', ['山の峰', '峰']]],
    products: [['ハイボール', 'ハイボール', ['ハイボール', 'ハイボ']], ['濃いめハイボール', 'コイメハイボール', ['濃いめハイボール', '濃いめ']]],
    sizes: [S('350ml 缶', P350C, 24, 190, '350カン'), S('500ml 缶', P500C, 24, 250, '500カン')] },
  { cat: '日本酒焼酎', brands: [['雪蔵', 'ユキグラ', ['雪蔵', '雪']], ['薩摩の郷', 'サツマノサト', ['薩摩', '郷']]],
    products: [['純米酒', 'ジュンマイシュ', ['純米', '純米酒']], ['本醸造', 'ホンジョウゾウ', ['本醸造', '本醸']], ['芋焼酎', 'イモジョウチュウ', ['芋', '芋焼酎']], ['麦焼酎', 'ムギジョウチュウ', ['麦焼酎', '麦']]],
    sizes: [S('1.8L 瓶', P18, 6, 1450, '1.8L'), S('900ml 瓶', ['900ml', '900', '四合瓶'], 12, 780, '900')] },
  { cat: '調味料', brands: [['ヤマ正', 'ヤマショウ', ['ヤマ正', '正']], ['海老原', 'エビハラ', ['海老原', '海老']]],
    products: [['濃口醤油', 'コイクチショウユ', ['濃口', '醤油']], ['薄口醤油', 'ウスクチショウユ', ['薄口', '薄口醤油']], ['本みりん', 'ホンミリン', ['みりん', '本みりん']], ['料理酒', 'リョウリシュ', ['料理酒', '酒']], ['米酢', 'コメズ', ['米酢', '酢']]],
    sizes: [S('1L', P1L, 12, 380, '1L'), S('1.8L', ['1.8L', '1800ml', '一升'], 6, 640, '1.8L'), S('5L 業務用', ['5L', '5リットル', '業務用'], 3, 1480, '5L')] },
];

// ---- 商品マスター ----
const master = [];
let seq = 1;
for (const c of CAT) for (const b of c.brands) for (const p of c.products) for (const s of c.sizes) {
  const code = 'P' + String(seq++).padStart(4, '0');
  master.push({ code, cat: c.cat, brand: b, prod: p, size: s, name: `${b[0]} ${p[0]} ${s.label}`, kana: `${b[1]} ${p[1]} ${s.kana}`, pack: s.pack, caseYen: Math.round((s.unit * s.pack) / 10) * 10 });
}
const byCode = new Map(master.map((m) => [m.code, m]));
const byCat = new Map();
for (const m of master) { if (!byCat.has(m.cat)) byCat.set(m.cat, []); byCat.get(m.cat).push(m); }

// ---- 得意先 ----
// cats: 扱うカテゴリと、そのカテゴリで常備する商品数。style: 注文文面の書き方の癖
const CUST = [
  { id: 'C01', name: '居酒屋 灯', type: '居酒屋', style: 'terse', cats: { ビール: 3, 酎ハイ: 3, ハイボール: 1, 日本酒焼酎: 3, 水: 1, 茶: 2, 清涼: 1 } },
  { id: 'C02', name: 'ラーメン 麺屋一凛', type: 'ラーメン店', style: 'abbrev', cats: { ビール: 2, 茶: 2, 清涼: 2, 水: 1, 調味料: 4 } },
  { id: 'C03', name: 'カフェ ソレイユ', type: 'カフェ', style: 'formal', cats: { コーヒー: 3, 果汁: 3, 茶: 2, 水: 2, 清涼: 2 } },
  { id: 'C04', name: 'ホテル 湖畔亭', type: 'ホテル', style: 'formal', cats: { ビール: 3, 水: 2, 茶: 3, 果汁: 3, コーヒー: 2, 日本酒焼酎: 2, 清涼: 2 } },
  { id: 'C05', name: '社員食堂 北星工業', type: '社員食堂', style: 'abbrev', cats: { 茶: 4, 水: 2, コーヒー: 3, 果汁: 2, スポーツ: 2, 調味料: 3 } },
  { id: 'C06', name: '焼肉 牛角庵', type: '焼肉店', style: 'kana', cats: { ビール: 3, 酎ハイ: 3, ハイボール: 2, 清涼: 3, 茶: 2, 日本酒焼酎: 1 } },
  { id: 'C07', name: '弁当 まごころ屋', type: '弁当店', style: 'terse', cats: { 茶: 3, 水: 2, 調味料: 5, 清涼: 1 } },
  { id: 'C08', name: 'スポーツクラブ フィット', type: 'スポーツクラブ', style: 'kana', cats: { スポーツ: 3, 水: 2, 茶: 3, コーヒー: 2, 果汁: 2 } },
  { id: 'C09', name: '寿司 匠あきら', type: '寿司店', style: 'formal', cats: { ビール: 2, 日本酒焼酎: 4, 茶: 3, 水: 2, 調味料: 3 } },
  { id: 'C10', name: 'ダイニング 森のテラス', type: 'ダイニング', style: 'abbrev', cats: { ビール: 2, 酎ハイ: 2, ハイボール: 2, 果汁: 2, 清涼: 2, 水: 2, コーヒー: 2, 日本酒焼酎: 2 } },
];
// 文面の癖ごとの、ブランド名・規格を書く確率。実データでは得意先ごとに違うので、ここでは仮に置いた値
const STYLE = {
  formal: { pBrand: 0.70, pSize: 0.85, units: ['ケース', 'ケース', 'ケース'], fullwidth: 0.15, halfKana: 0 },
  abbrev: { pBrand: 0.35, pSize: 0.70, units: ['ケース', 'c', 'cs', 'ケ'], fullwidth: 0.05, halfKana: 0 },
  kana: { pBrand: 0.50, pSize: 0.60, units: ['ケース', 'ケース', 'ケ'], fullwidth: 0.05, halfKana: 0.35 },
  terse: { pBrand: 0.20, pSize: 0.60, units: ['c', 'cs', 'C'], fullwidth: 0, halfKana: 0 },
};

// ---- かご(その得意先がいつも買う商品):商品ごとに、ブランドと規格を1つに決める ----
for (const cu of CUST) {
  cu.basket = [];
  for (const [cat, n] of Object.entries(cu.cats)) {
    const prods = [...new Set(byCat.get(cat).map((m) => m.prod[0]))];
    for (const pn of shuffle(prods).slice(0, n)) cu.basket.push(pick(byCat.get(cat).filter((m) => m.prod[0] === pn)).code);
  }
  // 購買履歴:直近半年に12回の注文があった想定。各回8〜12行を、かごから頻度の偏りをつけて選ぶ
  const w = cu.basket.map(() => Math.exp(R() * 2.2));
  const total = w.reduce((a, b) => a + b, 0);
  const cnt = new Map(cu.basket.map((c) => [c, 0]));
  for (let o = 0; o < 12; o++) {
    const k = 8 + Math.floor(R() * 5);
    const idx = new Set();
    while (idx.size < Math.min(k, cu.basket.length)) {
      let r = R() * total;
      let i = 0;
      while (i < w.length - 1 && r > w[i]) { r -= w[i]; i++; }
      idx.add(i);
    }
    for (const i of idx) cnt.set(cu.basket[i], cnt.get(cu.basket[i]) + 1);
  }
  for (const [c, n] of cnt) if (n === 0) cnt.set(c, 1);
  cu.history = cnt;
}

// ---- 注文の1行を作る ----
const FW = { 0: '0', 1: '1', 2: '2', 3: '3', 4: '4', 5: '5', 6: '6', 7: '7', 8: '8', 9: '9' };
const toFullDigits = (s) => s.replace(/[0-9]/g, (d) => FW[d]);
const HK = { ァ: 'ァ', ア: 'ア', ィ: 'ィ', イ: 'イ', ゥ: 'ゥ', ウ: 'ウ', ェ: 'ェ', エ: 'エ', ォ: 'ォ', オ: 'オ', カ: 'カ', キ: 'キ', ク: 'ク', ケ: 'ケ', コ: 'コ', サ: 'サ', シ: 'シ', ス: 'ス', セ: 'セ', ソ: 'ソ', タ: 'タ', チ: 'チ', ッ: 'ッ', ツ: 'ツ', テ: 'テ', ト: 'ト', ナ: 'ナ', ニ: 'ニ', ヌ: 'ヌ', ネ: 'ネ', ノ: 'ノ', ハ: 'ハ', ヒ: 'ヒ', フ: 'フ', ヘ: 'ヘ', ホ: 'ホ', マ: 'マ', ミ: 'ミ', ム: 'ム', メ: 'メ', モ: 'モ', ャ: 'ャ', ヤ: 'ヤ', ュ: 'ュ', ユ: 'ユ', ョ: 'ョ', ヨ: 'ヨ', ラ: 'ラ', リ: 'リ', ル: 'ル', レ: 'レ', ロ: 'ロ', ワ: 'ワ', ヲ: 'ヲ', ン: 'ン', ー: 'ー' };
// 全角カタカナを半角カタカナにする(濁点・半濁点のついた文字は2文字に分ける)
function halfKana(s) {
  return [...s].map((ch) => {
    if (HK[ch]) return HK[ch];
    const d = ch.normalize('NFD');
    if (d.length === 2 && HK[d[0]]) return HK[d[0]] + (d[1] === String.fromCharCode(0x3099) ? '゙' : '゚');
    return ch;
  }).join('');
}
// 誤記:漢字・かなの1文字を落とす
const typo = (s) => {
  const cs = [...s];
  const idx = cs.map((c, i) => (/[^\d\sA-Za-z]/.test(c) ? i : -1)).filter((i) => i >= 0);
  if (idx.length < 3) return s;
  cs.splice(pick(idx), 1);
  return cs.join('');
};

function makeLine(cu, m, isNew) {
  const st = STYLE[cu.style];
  const usual = !isNew && chance(0.06); // 「いつもの」と書く行(既存品のみ)。ブランドも規格も省略される
  const showBrand = !usual && chance(st.pBrand);
  const showSize = !usual && chance(st.pSize);
  let brand = m.brand[0];
  let prod = m.prod[0];
  if (cu.style === 'abbrev' || cu.style === 'terse') { brand = pick(m.brand[2]); prod = pick(m.prod[2]); }
  if (cu.style === 'kana') { brand = m.brand[1]; prod = m.prod[1]; }
  const size = pick(m.size.say);
  let item;
  if (cu.style === 'terse') item = `${showBrand ? brand : ''}${prod}${showSize ? size : ''}`;
  else item = [showBrand ? brand : '', prod, showSize ? size : ''].filter(Boolean).join(chance(0.7) ? ' ' : '');
  if (usual) item = 'いつもの' + prod;
  if (chance(0.07)) item = typo(item);
  // 数量:ほとんどはケース単位。1割はバラ(本)単位
  let qty, unit, bottles;
  if (chance(0.10)) { qty = 1 + Math.floor(R() * 12); unit = '本'; bottles = qty; }
  else { qty = 1 + Math.floor(R() * 8); unit = 'ケース'; bottles = qty * m.pack; }
  const uw = unit === '本' ? pick(['本', 'バラ', 'バラ']) : pick(st.units);
  const qtyText = unit === '本' && uw !== '本' ? `${uw}${qty}本` : `${qty}${uw}`;
  let text = chance(0.5) ? `${item} ${qtyText}` : `${item}${qtyText}`;
  if (chance(st.fullwidth)) text = toFullDigits(text);
  if (chance(st.halfKana)) text = halfKana(text);
  return { text, truth: m.code, qty, unit, bottles, showBrand: showBrand ? 1 : 0, showSize: showSize ? 1 : 0, usual: usual ? 1 : 0 };
}

const orders = [];
let ln = 1;
for (const cu of CUST) {
  const inBasket = new Set(cu.basket);
  // 既存品10行:かごから重複なしで選ぶ。購入回数が多い商品ほど選ばれやすい
  const pool = cu.basket.map((c) => ({ c, w: cu.history.get(c) }));
  const chosen = [];
  while (chosen.length < 10) {
    const tot = pool.reduce((a, b) => a + b.w, 0);
    let r = R() * tot;
    let i = 0;
    while (i < pool.length - 1 && r > pool[i].w) { r -= pool[i].w; i++; }
    chosen.push(pool[i].c);
    pool.splice(i, 1);
  }
  // 新規品2行:その得意先が扱うカテゴリのうち、かごに無い商品(購買履歴にも無い)
  const cand = master.filter((m) => cu.cats[m.cat] && !inBasket.has(m.code));
  const news = shuffle(cand).slice(0, 2).map((m) => m.code);
  const lines = shuffle([...chosen.map((c) => [c, 0]), ...news.map((c) => [c, 1])]);
  for (const [code, isNew] of lines) orders.push({ id: 'L' + String(ln++).padStart(3, '0'), cust: cu.id, isNew, ...makeLine(cu, byCode.get(code), isNew) });
}

// ---- CSVで書き出す ----
const q = (v) => { v = String(v); return /[",\n]/.test(v) ? '"' + v.replace(/"/g, '""') + '"' : v; };
const csv = (rows) => rows.map((r) => r.map(q).join(',')).join('\n') + '\n';
fs.mkdirSync(OUT, { recursive: true });
fs.writeFileSync(`${OUT}/master.csv`, csv([['商品コード', '商品名', '商品名カナ', '入数', 'ケース単価', '分類'], ...master.map((m) => [m.code, m.name, m.kana, m.pack, m.caseYen, m.cat])]));
fs.writeFileSync(`${OUT}/customers.csv`, csv([['得意先コード', '得意先名', '業態'], ...CUST.map((c) => [c.id, c.name, c.type])]));
fs.writeFileSync(`${OUT}/history.csv`, csv([['得意先コード', '商品コード', '直近半年の購入回数'], ...CUST.flatMap((c) => [...c.history].map(([code, n]) => [c.id, code, n]))]));
fs.writeFileSync(`${OUT}/orders.csv`, csv([['行ID', '得意先コード', '注文の文面'], ...orders.map((o) => [o.id, o.cust, o.text])]));
// 正解は別ファイルに分ける。候補づくりと選択のスクリプトはこのファイルを読まない
fs.writeFileSync(`${OUT}/truth.csv`, csv([['行ID', '正解の商品コード', '数量', '単位', '本数換算', '新規品', 'ブランド明記', '規格明記', 'いつもの'], ...orders.map((o) => [o.id, o.truth, o.qty, o.unit, o.bottles, o.isNew, o.showBrand, o.showSize, o.usual])]));
console.log(`種 ${SEED} / 出力先 ${OUT}: 商品 ${master.length}件 / 得意先 ${CUST.length}件 / 購買履歴 ${CUST.reduce((a, c) => a + c.history.size, 0)}行 / 注文の行 ${orders.length}行(新規品 ${orders.filter((o) => o.isNew).length}行)`);
candidates.mjs(3-3:候補を8件に絞る)
// candidates.mjs: 注文の1行ごとに、商品マスターから候補を8件に絞る(3通りのやり方)。正解のファイル(truth.csv)は読まない。
// a: 文字の近さだけで絞る(文字のn-gramによるTF-IDF類似度)
// b: 意味の近さで絞る(多言語の埋め込みモデル multilingual-e5-small のコサイン類似度)
// c: bに購買履歴を足す(その得意先が過去に買った商品から4件、残りは全商品から意味の近い順に埋める)
import fs from 'node:fs';
import { pipeline } from '@huggingface/transformers';
import { readCsv } from './lib.mjs';
const K = 8; // 候補の件数
const K_HISTORY = 4; // cで、購買履歴のある商品に割り当てる枠
// --data でデータの置き場所を変えられる(既定は data)。別の乱数の種で作ったデータを使うときに指定する
const argv = process.argv.slice(2);
const DATA = argv.includes('--data') ? argv[argv.indexOf('--data') + 1] : 'data';
const master = readCsv(`${DATA}/master.csv`);
const orders = readCsv(`${DATA}/orders.csv`);
const history = readCsv(`${DATA}/history.csv`);
const histBy = new Map();
for (const h of history) { if (!histBy.has(h['得意先コード'])) histBy.set(h['得意先コード'], new Set()); histBy.get(h['得意先コード']).add(h['商品コード']); }
// 前処理:全角を半角に揃え、小文字にし、数量の部分(3ケース、5c、バラ12本など)を取り除く
const norm = (s) => s.normalize('NFKC').toLowerCase();
const stripQty = (s) => s.replace(/(?:バラ)?\s*\d+\s*(?:ケース|ケ|cs|c|本)(?![a-z゠-ヿ-ゟ一-鿿])/g, ' ').replace(/\s+/g, ' ').trim();
const cleaned = (t) => stripQty(norm(t));
// ひらがなをカタカナに揃える(aの文字比較でだけ使う)
const fold = (s) => s.replace(/[ぁ-ゖ]/g, (ch) => String.fromCharCode(ch.charCodeAt(0) + 0x60));
// ---- a: 文字n-gram(2文字と3文字)のTF-IDF ----
const grams = (s) => { s = fold(s).replace(/\s+/g, ''); const g = []; for (const n of [2, 3]) for (let i = 0; i + n <= s.length; i++) g.push(s.slice(i, i + n)); return g; };
const docs = master.map((m) => grams(norm(`${m['商品名']} ${m['商品名カナ']}`)));
const df = new Map();
for (const d of docs) for (const g of new Set(d)) df.set(g, (df.get(g) || 0) + 1);
const idf = (g) => Math.log(1 + docs.length / (df.get(g) || 0.5));
const vec = (gs) => { const v = new Map(); for (const g of gs) v.set(g, (v.get(g) || 0) + idf(g)); const nrm = Math.sqrt([...v.values()].reduce((a, b) => a + b * b, 0)) || 1; for (const [g, x] of v) v.set(g, x / nrm); return v; };
const docVec = docs.map(vec);
const cosSparse = (a, b) => { let s = 0; for (const [g, x] of a) { const y = b.get(g); if (y) s += x * y; } return s; };
// ---- b: 埋め込み ----
const ext = await pipeline('feature-extraction', 'Xenova/multilingual-e5-small', { dtype: 'q8' });
const embed = async (texts) => { const out = await ext(texts, { pooling: 'mean', normalize: true }); const d = out.dims[1]; return texts.map((_, i) => Array.from(out.data.slice(i * d, (i + 1) * d))); };
const dot = (a, b) => { let s = 0; for (let i = 0; i < a.length; i++) s += a[i] * b[i]; return s; };
const passVec = await embed(master.map((m) => `passage: ${m['商品名']} ${m['商品名カナ']}`));
const queryVec = await embed(orders.map((o) => `query: ${cleaned(o['注文の文面'])}`));
const top = (scores, k, allow) => scores.map((s, i) => [s, i]).filter(([, i]) => !allow || allow.has(master[i]['商品コード'])).sort((x, y) => y[0] - x[0] || x[1] - y[1]).slice(0, k).map(([, i]) => master[i]['商品コード']);
const out = { a: {}, b: {}, c: {}, cleaned: {} };
orders.forEach((o, li) => {
const id = o['行ID'];
const text = cleaned(o['注文の文面']);
out.cleaned[id] = text;
const qa = vec(grams(text));
out.a[id] = top(docVec.map((d) => cosSparse(qa, d)), K);
const sb = passVec.map((p) => dot(queryVec[li], p));
out.b[id] = top(sb, K);
const H = histBy.get(o['得意先コード']) || new Set();
const fromHist = top(sb, K_HISTORY, H);
const rest = top(sb, master.length).filter((c) => !fromHist.includes(c)).slice(0, K - fromHist.length);
out.c[id] = [...fromHist, ...rest];
});
fs.writeFileSync(`${DATA}/candidates.json`, JSON.stringify(out, null, 1));
console.log(`候補を作りました: ${DATA} / 注文の行 ${orders.length} 件 x 3通り(各${K}件)`);select.mjs(3-5:LLMに1件を選ばせる)
// select.mjs: 絞った候補の中から、LLMに注文の1行に合う商品を1つ選ばせる(selecting)。正解のファイル(truth.csv)は読まない。
// 使い方: node select.mjs <実行名> [--limit 件数] [--only a,b,c] [--data フォルダ] [--prompt v1|v2]
//   --data   : データの置き場所(既定は data)
//   --prompt : 指示文の版(既定は v1)。v2 は v1 の誤りを見て書き直したもの
// 結果は results/<実行名>.jsonl に1行ずつ追記する。途中で止めても、同じコマンドで続きから再開できる。
// 実行名ごとに1ファイルにする。データや指示文を変えるときは、実行名も変える。
import fs from 'node:fs';
import os from 'node:os';
import { spawn } from 'node:child_process';
import { readCsv } from './lib.mjs';

const RUN = process.argv[2] || 'run1';
const args = process.argv.slice(3);
const LIMIT = args.includes('--limit') ? Number(args[args.indexOf('--limit') + 1]) : Infinity;
const ONLY = args.includes('--only') ? args[args.indexOf('--only') + 1].split(',') : ['a', 'b', 'c'];
const DATA = args.includes('--data') ? args[args.indexOf('--data') + 1] : 'data';
const PROMPT = args.includes('--prompt') ? args[args.indexOf('--prompt') + 1] : 'v1';
const MODEL = 'haiku'; // claude-haiku-4-5
const CONCURRENCY = 6;

const master = new Map(readCsv(`${DATA}/master.csv`).map((m) => [m['商品コード'], m]));
const custs = new Map(readCsv(`${DATA}/customers.csv`).map((c) => [c['得意先コード'], c]));
const orders = readCsv(`${DATA}/orders.csv`).slice(0, LIMIT);
const cands = JSON.parse(fs.readFileSync(`${DATA}/candidates.json`, 'utf8'));
const hist = new Map(); // 得意先コード -> (商品コード -> 購入回数)
for (const h of readCsv(`${DATA}/history.csv`)) {
  if (!hist.has(h['得意先コード'])) hist.set(h['得意先コード'], new Map());
  hist.get(h['得意先コード']).set(h['商品コード'], Number(h['直近半年の購入回数']));
}

const SYSTEM = 'あなたは卸売会社の受注入力を補助するAIです。FAXやメールで届いた注文の1行を読み、候補一覧の中から該当する商品を1つ選びます。出力はJSONだけにします。';

// 候補一覧の文字列を作る(v1・v2で共通)
function buildCandidateLines(v, order) {
  const codes = [...cands[v][order['行ID']]].sort(); // 検索の順位が分からないよう、商品コード順に並べる
  const useHist = v === 'c';
  return codes.map((code, i) => {
    const m = master.get(code);
    const n = hist.get(order['得意先コード'])?.get(code) || 0;
    return `${i + 1}. ${code} | ${m['商品名']} | 入数${m['入数']}本 | ケース単価${m['ケース単価']}円` + (useHist ? ` | この得意先の直近半年の購入回数: ${n ? n + '回' : 'なし'}` : '');
  });
}

function buildPromptV1(v, order) {
  const cu = custs.get(order['得意先コード']);
  const useHist = v === 'c';
  const lines = buildCandidateLines(v, order);
  return [
    `【得意先】${cu['得意先名']}(${cu['業態']})`,
    `【注文の1行】${order['注文の文面']}`,
    '',
    '【候補】',
    ...lines,
    '',
    '【読み方のルール】',
    '- ケース、ケース、ケ、c、cs は1ケース(その商品の入数ぶん)を表す。バラ、本 は1本を表す。',
    '- 候補の中に該当する商品が無いときは、selected を 0 にする。',
    useHist ? '- 注文の文面と購入回数の両方を見ても複数の候補を区別できないときは、confidence を 50 以下にする。' : '- 注文の文面だけでは複数の候補を区別できないときは、confidence を 50 以下にする。',
    useHist ? '- 文面と購入回数から1つに絞れ、ほかの候補と取り違える余地がないときだけ、confidence を 90 以上にする。' : '- 文面が候補の1つとはっきり一致し、ほかの候補と取り違える余地がないときだけ、confidence を 90 以上にする。',
    ...(useHist ? ['- 購入回数は参考情報である。文面がほかの商品をはっきり指しているときは、購入回数より文面を優先する。'] : []),
    '',
    '【出力】次のJSONだけを出力する。',
    '{"selected": 候補の番号(0は該当なし), "quantity": 数量(整数), "unit": "ケース" または "本", "confidence": 0から100の整数, "reason": "20字以内の理由"}',
  ].join('\n');
}

// v2: v1 の誤りを見て書き直した指示文。
// 直した点は4つ。①考える順序を指定する ②規格の数字と数量の数字を分ける ③ブランド名と商品名の取り違えを止める
// ④confidence を4段階の具体的な基準にする(v1は「90以上にするのは〜のときだけ」としか書いておらず、正解でも80前後に寄っていた)
function buildPromptV2(v, order) {
  const cu = custs.get(order['得意先コード']);
  const useHist = v === 'c';
  const lines = buildCandidateLines(v, order);
  return [
    `【得意先】${cu['得意先名']}(${cu['業態']})`,
    `【注文の1行】${order['注文の文面']}`,
    '',
    '【候補】',
    ...lines,
    '',
    '【手順】この順で考える。',
    '1. 文面を「商品を表す部分」と「数量を表す部分」に分ける',
    '2. 商品を表す部分の語を、候補の商品名と1語ずつ照合する',
    ...(useHist ? ['3. それでも候補が複数残るときだけ、購入回数を使う'] : ['3. それでも候補が複数残るときは、確信度を下げる']),
    '',
    '【文面の読み方】',
    '- ケース、ケース、ケ、c、cs は1ケース(その商品の入数ぶん)を表す。バラ、本 は1本を表す。',
    '- 数字が続いているときは、規格の数字と数量の数字を分ける。',
    '  例「ビール6336ケース」は、633ml(規格)が6ケース(数量)である。',
    '- 規格を表す数字: 185、190、350、500、633、900、1L、1.5L、1.8L、2L、5L など。',
    '  これらは数量ではない。数量は、ケースや本を表す語の直前にある数字である。',
    '- 半角カナ、全角数字、1文字の誤記がありうる。表記の違いは無視して照合する。',
    '',
    '【候補の選び方】',
    '- ブランド名に含まれる語を、商品名と取り違えない。',
    '  例「麦」は、商品名の「麦茶」を指すことも、ブランド名の「麦の穂」を指すこともある。',
    '  どちらか判断できないときは、どちらかに決めつけず、confidence を下げる。',
    ...(useHist ? [
      '- 購入回数が「なし」の商品も、同じように選んでよい。',
      '  得意先が初めて注文する商品がある。購入回数が「なし」であることは、候補から外す理由にならない。',
      '- 文面の語が候補の1件とだけ一致するなら、購入回数が多い別の候補ではなく、一致した方を選ぶ。',
      '- 選んだ理由と、選んだ商品を一致させる。',
      '  「購入回数が最多だから」と書くなら、実際に購入回数が最多の商品を選ぶ。',
    ] : []),
    '- 候補の中に該当する商品が無いときは、selected を 0 にする。',
    '',
    '【confidence の付け方】次の4つから選ぶ。ほかの数字は使わない。',
    '- 95: 文面の語(ブランド・商品名・規格)が候補1件とすべて一致し、ほかの候補と区別できる',
    '- 90: 文面に書かれている語だけで1件に絞れる。文面に省略はあるが、書かれている語は1件としか一致しない',
    ...(useHist ? ['- 70: 文面では候補が複数残り、購入回数で1件を選んだ'] : ['- 70: 文面では候補が複数残り、最も近いものを選んだ']),
    '- 40: どの候補か決められず、推測で選んだ',
    '',
    '【出力】次のJSONだけを出力する。',
    '{"selected": 候補の番号(0は該当なし), "quantity": 数量(整数), "unit": "ケース" または "本", '
      + '"confidence": 95/90/70/40 のいずれか, '
      + `"decided_by": ${useHist ? '"文面" / "購入回数" / "推測" のいずれか' : '"文面" / "推測" のいずれか'}, `
      + '"reason": "30字以内の理由"}',
  ].join('\n');
}

const buildPrompt = PROMPT === 'v2' ? buildPromptV2 : buildPromptV1;

function callClaude(prompt) {
  return new Promise((resolve) => {
    const t0 = Date.now();
    const p = spawn('claude', ['-p', '--model', MODEL, '--tools', '', '--system-prompt', SYSTEM, '--no-session-persistence', '--disable-slash-commands', '--strict-mcp-config', '--output-format', 'json'], { cwd: os.tmpdir() });
    let out = '';
    let err = '';
    const timer = setTimeout(() => p.kill(), 180000);
    p.stdout.on('data', (d) => (out += d));
    p.stderr.on('data', (d) => (err += d));
    p.on('close', () => {
      clearTimeout(timer);
      try {
        const j = JSON.parse(out);
        resolve({ text: j.result ?? '', cost: j.total_cost_usd ?? 0, ms: Date.now() - t0 });
      } catch { resolve({ text: '', cost: 0, ms: Date.now() - t0, error: (err || out).slice(0, 200) }); }
    });
    p.stdin.end(prompt);
  });
}
// 返答からJSONを取り出して、形を確かめる
function parse(text) {
  const m = text.match(/\{[\s\S]*\}/);
  if (!m) return null;
  try {
    const j = JSON.parse(m[0]);
    if (!Number.isInteger(j.selected) || !Number.isFinite(Number(j.quantity)) || !['ケース', '本'].includes(j.unit) || !Number.isFinite(Number(j.confidence))) return null;
    // decided_by は v2 の指示文でだけ返る。v1 では undefined になる
    return { selected: j.selected, quantity: Number(j.quantity), unit: j.unit, confidence: Number(j.confidence), decided_by: j.decided_by ? String(j.decided_by) : undefined, reason: String(j.reason || '') };
  } catch { return null; }
}

fs.mkdirSync('results', { recursive: true });
const file = `results/${RUN}.jsonl`;
const done = new Set(fs.existsSync(file) ? fs.readFileSync(file, 'utf8').split('\n').filter(Boolean).map((l) => JSON.parse(l)).filter((r) => r.parsed).map((r) => `${r.variant}|${r.id}`) : []);
const jobs = [];
for (const v of ONLY) for (const o of orders) if (!done.has(`${v}|${o['行ID']}`)) jobs.push({ v, o });
console.log(`実行名 ${RUN}(データ ${DATA} / 指示文 ${PROMPT} / 対象 ${ONLY.join(',')}): ${jobs.length}件を処理します(済み ${done.size}件)`);

// --show-prompt: 最初の1件ぶんの指示文を表示して終わる。LLMは呼ばないので費用はかからない
if (args.includes('--show-prompt')) {
  if (!jobs.length) { console.log('(処理する行がありません)'); process.exit(0); }
  const { v, o } = jobs[0];
  console.log(`\n--- ${v} / ${o['行ID']} に渡す指示文(${PROMPT})---\n`);
  console.log(buildPrompt(v, o));
  process.exit(0);
}

let idx = 0;
let finished = 0;
async function worker() {
  while (idx < jobs.length) {
    const { v, o } = jobs[idx++];
    const prompt = buildPrompt(v, o);
    let r = await callClaude(prompt);
    let parsed = parse(r.text);
    if (!parsed) { r = await callClaude(prompt); parsed = parse(r.text); } // 形が崩れたときだけ、もう1回だけ聞き直す
    fs.appendFileSync(file, JSON.stringify({ variant: v, id: o['行ID'], data: DATA, prompt: PROMPT, parsed, raw: parsed ? undefined : r.text.slice(0, 300), error: r.error, cost: r.cost, ms: r.ms }) + '\n');
    if (++finished % 20 === 0) console.log(`  ${finished}/${jobs.length}`);
  }
}
await Promise.all(Array.from({ length: CONCURRENCY }, worker));
console.log('完了');
evaluate.mjs(3-6から3-8:正解と突き合わせて集計する)
// evaluate.mjs: 選ばれた結果を、正解(truth.csv)と突き合わせて集計する。
// 使い方: node evaluate.mjs <実行名> [<実行名> ...] [--data フォルダ]
//   複数の実行名を渡すと、実行ごとの表を並べて出す。指示文 v1 と v2 を比べるときはこの形を使う
//   --data は、その実行に使ったデータの置き場所(既定は data)
import fs from 'node:fs';
import { readCsv } from './lib.mjs';

const argvAll = process.argv.slice(2);
const DATA = argvAll.includes('--data') ? argvAll[argvAll.indexOf('--data') + 1] : 'data';
const runs = argvAll.filter((a, i) => a !== '--data' && argvAll[i - 1] !== '--data');
if (!runs.length) { console.error('実行名を渡してください'); process.exit(1); }
const master = new Map(readCsv(`${DATA}/master.csv`).map((m) => [m['商品コード'], m]));
const truth = new Map(readCsv(`${DATA}/truth.csv`).map((t) => [t['行ID'], t]));
const cands = JSON.parse(fs.readFileSync(`${DATA}/candidates.json`, 'utf8'));
const THRESHOLDS = [50, 70, 80, 90, 95];
const MAIN_T = 90; // 自動登録に回すしきい値。結果を見る前に90と決めていた
const pct = (a, b) => (b ? (100 * a / b).toFixed(1) + '%' : '-');

function load(run) {
  const rows = new Map();
  for (const l of fs.readFileSync(`results/${run}.jsonl`, 'utf8').split('\n').filter(Boolean)) { const r = JSON.parse(l); rows.set(`${r.variant}|${r.id}`, r); }
  return rows;
}

// 1行ぶんの判定。sku: 商品が合っているか / full: 商品も本数も合っているか(受注の1行としてそのまま登録できるか)
function judge(v, id, r) {
  const t = truth.get(id);
  const p = r?.parsed;
  const sorted = [...cands[v][id]].sort();
  const chosen = p && p.selected >= 1 && p.selected <= sorted.length ? sorted[p.selected - 1] : null;
  const sku = chosen === t['正解の商品コード'];
  const bottles = chosen ? (p.unit === 'ケース' ? p.quantity * Number(master.get(chosen)['入数']) : p.quantity) : null;
  const full = sku && bottles === Number(t['本数換算']);
  const inCand = cands[v][id].includes(t['正解の商品コード']);
  return { t, p, chosen, sku, full, inCand, conf: p ? p.confidence : -1 };
}

const out = [];
for (const run of runs) {
  const rows = load(run);
  const ids = [...truth.keys()];
  // その実行で実際に回した候補の作り方だけを集計する(cだけ回したときに a・b が0%で並ばないようにする)
  const VS = ['a', 'b', 'c'].filter((v) => ids.some((id) => rows.has(`${v}|${id}`)));
  let cost = 0, fail = 0;
  for (const r of rows.values()) { cost += r.cost || 0; if (!r.parsed) fail++; }
  out.push(`\n## 実行 ${run}(${rows.size}件の返答、形が崩れて読めなかった返答 ${fail}件、費用の合計 ${cost.toFixed(2)}ドル)\n`);

  // 表1:候補の段階と、LLMが選んだ段階
  out.push('### 表1 候補に正解が入った割合と、LLMが正解を選んだ割合\n');
  out.push('| 候補の作り方 | 候補8件に正解が入った | 商品が合っていた | 商品も本数も合っていた |');
  out.push('| --- | --- | --- | --- |');
  const names = { a: 'a 文字の近さ', b: 'b 意味の近さ', c: 'c 意味の近さ+購買履歴' };
  const J = {};
  for (const v of VS) {
    J[v] = ids.map((id) => judge(v, id, rows.get(`${v}|${id}`)));
    const n = ids.length;
    out.push(`| ${names[v]} | ${pct(J[v].filter((x) => x.inCand).length, n)}(${J[v].filter((x) => x.inCand).length}/${n}) | ${pct(J[v].filter((x) => x.sku).length, n)}(${J[v].filter((x) => x.sku).length}/${n}) | ${pct(J[v].filter((x) => x.full).length, n)}(${J[v].filter((x) => x.full).length}/${n}) |`);
  }

  // 表2:しきい値ごとの自動登録
  out.push('\n### 表2 確信度のしきい値ごとの、自動登録と人の確認\n');
  out.push('| 候補の作り方 | しきい値 | 自動登録 | 自動登録のうち誤り(誤登録) | 誤登録の割合 | 人が確認する行 |');
  out.push('| --- | --- | --- | --- | --- | --- |');
  for (const v of VS) for (const T of THRESHOLDS) {
    const auto = J[v].filter((x) => x.p && x.chosen && x.conf >= T);
    const ng = auto.filter((x) => !x.full);
    out.push(`| ${names[v]} | ${T}${T === MAIN_T ? '(主)' : ''} | ${auto.length}件(${pct(auto.length, ids.length)}) | ${ng.length}件 | ${pct(ng.length, auto.length)} | ${ids.length - auto.length}件 |`);
  }

  // 表3:しきい値90で、行の種類ごとに見る
  out.push(`\n### 表3 しきい値${MAIN_T}での、行の種類ごとの結果(商品も本数も合った割合 / 自動登録件数 / 誤登録件数)\n`);
  const groups = [
    ['既存品(購買履歴にある)', (x) => x.t['新規品'] === '0'],
    ['新規品(購買履歴にない)', (x) => x.t['新規品'] === '1'],
    ['ブランドも規格も書いてない行', (x) => x.t['ブランド明記'] === '0' && x.t['規格明記'] === '0'],
    ['ブランドか規格のどちらかは書いてある行', (x) => x.t['ブランド明記'] === '1' || x.t['規格明記'] === '1'],
  ];
  out.push('| 行の種類 | 行数 | ' + VS.map((v) => names[v]).join(' | ') + ' |');
  out.push('| --- | --- | ' + VS.map(() => '---').join(' | ') + ' |');
  for (const [label, f] of groups) {
    const cells = VS.map((v) => {
      const xs = J[v].filter(f);
      const auto = xs.filter((x) => x.p && x.chosen && x.conf >= MAIN_T);
      return `${pct(xs.filter((x) => x.full).length, xs.length)} / ${auto.length} / ${auto.filter((x) => !x.full).length}`;
    });
    out.push(`| ${label} | ${J[VS[0]].filter(f).length} | ${cells.join(' | ')} |`);
  }

  // 表4:何を根拠に決めたか(指示文 v2 でだけ decided_by が返る)
  const hasDecided = VS.some((v) => J[v].some((x) => x.p && x.p.decided_by));
  if (hasDecided) {
    out.push('\n### 表4 AIが何を根拠に決めたかと、その正解率\n');
    out.push('| 候補の作り方 | 根拠 | 件数 | 商品も本数も合っていた | 自動登録(しきい値' + MAIN_T + ') |');
    out.push('| --- | --- | --- | --- | --- |');
    for (const v of VS) {
      const kinds = [...new Set(J[v].map((x) => (x.p && x.p.decided_by) || '(記載なし)'))];
      for (const k of kinds) {
        const xs = J[v].filter((x) => ((x.p && x.p.decided_by) || '(記載なし)') === k);
        const auto = xs.filter((x) => x.p && x.chosen && x.conf >= MAIN_T);
        out.push(`| ${names[v]} | ${k} | ${xs.length}件 | ${pct(xs.filter((x) => x.full).length, xs.length)} | ${auto.length}件 |`);
      }
    }
  }

  // 誤登録の中身
  out.push(`\n### 誤登録の内訳(しきい値${MAIN_T})\n`);
  for (const v of VS) {
    const bad = ids.map((id, i) => ({ id, x: J[v][i] })).filter(({ x }) => x.p && x.chosen && x.conf >= MAIN_T && !x.full);
    out.push(`- ${names[v]}: ${bad.length}件` + (bad.length ? '(' + bad.map(({ id, x }) => `${id}:${x.sku ? '本数' : '商品'}`).join('、') + ')' : ''));
  }
}
const text = out.join('\n');
fs.writeFileSync(`results/summary_${runs.join('_')}.md`, text);
console.log(text);
to_csv.mjs(3-9:ERPの取込用CSVにする)
// to_csv.mjs: LLMが選んだ結果を、既存ERPの取込用CSVの形に変換する。
// 正解のファイル(truth.csv)は読まない。実際の運用では正解が無いので、それと同じ条件で動かす。
// 使い方: node to_csv.mjs <実行名> [--data フォルダ] [--variant a|b|c] [--threshold 90]
//   確信度がしきい値以上の行は「自動登録」、それ未満は「要確認」として、状態の列に書き分ける。
//   出力は results/<実行名>_erp.csv。
import fs from 'node:fs';
import { readCsv } from './lib.mjs';

const RUN = process.argv[2];
const args = process.argv.slice(3);
if (!RUN) { console.error('実行名を渡してください'); process.exit(1); }
const DATA = args.includes('--data') ? args[args.indexOf('--data') + 1] : 'data';
const VARIANT = args.includes('--variant') ? args[args.indexOf('--variant') + 1] : 'c';
const THRESHOLD = args.includes('--threshold') ? Number(args[args.indexOf('--threshold') + 1]) : 90;

const master = new Map(readCsv(`${DATA}/master.csv`).map((m) => [m['商品コード'], m]));
const custs = new Map(readCsv(`${DATA}/customers.csv`).map((c) => [c['得意先コード'], c]));
const orders = readCsv(`${DATA}/orders.csv`);
const cands = JSON.parse(fs.readFileSync(`${DATA}/candidates.json`, 'utf8'));

// 実行結果を 行ID -> 返答 の形に読み込む
const rows = new Map();
for (const l of fs.readFileSync(`results/${RUN}.jsonl`, 'utf8').split('\n').filter(Boolean)) {
  const r = JSON.parse(l);
  if (r.variant === VARIANT) rows.set(r.id, r);
}

const q = (v) => { v = String(v ?? ''); return /[",\n]/.test(v) ? '"' + v.replace(/"/g, '""') + '"' : v; };
const out = [['行ID', '得意先コード', '得意先名', '注文の文面', '商品コード', '商品名', '数量', '単位', '本数換算', '確信度', '状態']];
let auto = 0, check = 0, unreadable = 0;

for (const o of orders) {
  const r = rows.get(o['行ID']);
  const p = r?.parsed;
  // 返答が読めなかった行と、該当なし(selected=0)の行は、商品を空にして人に回す
  const sorted = [...cands[VARIANT][o['行ID']]].sort(); // 指示文に出したのと同じ並び(商品コード順)
  const code = p && p.selected >= 1 && p.selected <= sorted.length ? sorted[p.selected - 1] : null;
  const m = code ? master.get(code) : null;
  const bottles = m ? (p.unit === 'ケース' ? p.quantity * Number(m['入数']) : p.quantity) : '';
  let status;
  if (!p) { status = '要確認(返答を読めず)'; unreadable++; }
  else if (!code) { status = '要確認(該当なし)'; check++; }
  else if (p.confidence >= THRESHOLD) { status = '自動登録'; auto++; }
  else { status = '要確認'; check++; }
  out.push([
    o['行ID'], o['得意先コード'], custs.get(o['得意先コード'])['得意先名'], o['注文の文面'],
    code || '', m ? m['商品名'] : '', p ? p.quantity : '', p ? p.unit : '', bottles,
    p ? p.confidence : '', status,
  ]);
}

const file = `results/${RUN}_erp.csv`;
fs.writeFileSync(file, out.map((r) => r.map(q).join(',')).join('\n') + '\n');
const n = orders.length;
console.log(`${file} を書き出しました(${VARIANT} / しきい値${THRESHOLD})`);
console.log(`  自動登録 ${auto}件(${(100 * auto / n).toFixed(1)}%) / 要確認 ${check + unreadable}件(うち返答を読めず ${unreadable}件)`);
console.log('\n--- 先頭3行 ---');
console.log(out.slice(0, 4).map((r) => r.join(',')).join('\n'));
最後に
私たちは、単にシステムを組むだけの開発会社ではありません。低コストで高品質なAIツールの構築から、ROI(投資対効果)を最大化する導入ロードマップの策定、社内スタッフが自らAIを運用・改善できる体制の構築まで、AI導入の成功に必要なすべてを最初から最後まで丸ごと支援いたします。
実は、ご相談いただく方のほとんどが「何が分からないかも分からない」という状態からのスタートです。構想段階でも、ただのアイデアベースでも構いません。
まずは、あなたのお困りごとをそのまま聞かせていただけませんか?貴社のビジネスを加速させるパートナーとして伴走いたします。
無料オンライン相談で、最適な導入プランを相談する
ご相談と資料
読んだ内容を、
自社の業務に当てはめたい方へ
どの業務から手を付けるか、何を作るかが決まっていなくても構いません。30分の無料相談で、今の状況から伺います。
ご相談はオンラインでも、京都・百万遍のオフィスでもお受けします。秘密保持契約を先に結ぶこともできます。
参考文献
- Ralph Peeters, Aaron Steiner, Christian Bizer「Entity Matching using Large Language Models」arXiv:2310.11244、EDBT 2025(28th International Conference on Extending Database Technology)採録(2026年9月19日参照)
- Aaron Steiner, Ralph Peeters, Christian Bizer「Fine-tuning Large Language Models for Entity Matching」arXiv:2409.08185v2、2025年5月21日(2026年9月19日参照)
- Tianshu Wang, Xiaoyang Chen, Hongyu Lin, Xuanang Chen, Xianpei Han, Hao Wang, Zhenyu Zeng, Le Sun「Match, Compare, or Select? An Investigation of Large Language Models for Entity Matching」arXiv:2405.16884、COLING 2025 採録(2026年9月19日参照)