ベイズ推論×Claude Codeで少数データの経営判断を数字にする
はじめに:12ヶ月ぶんの数字で施策の継続を決めていないでしょうか
半年前に始めた施策を続けるか、やめるか。手元にあるのは、施策前後を合わせて12ヶ月ぶんの数字だけ。分析担当からは有意差なしと返ってきた。それで会議が止まった経験はないでしょうか。
そこで候補に挙がるのがベイズ推論です。ベイズ統計のビジネス活用としてよく挙がる手法で、少数データでも判断しやすいと紹介されます。ただ、実際に計算すると、手法をベイズ推論へ替えるだけでは判断材料は増えませんでした。
今回の正規モデルに平坦な事前分布を置くと、ベイズ推論はt検定とほぼ同じ数字を返しました。t検定のp値は0.3020、ベイズ推論で求めた改善確率は0.8516。後者は、t検定の片側p値から得られる0.8490とほぼ一致します。表現は分かりやすくなっても、新しい情報が増えたわけではありません。
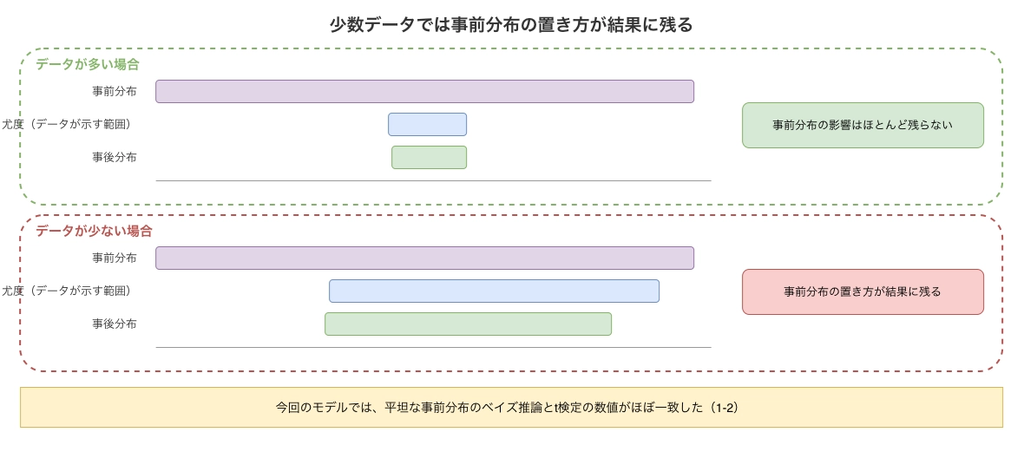
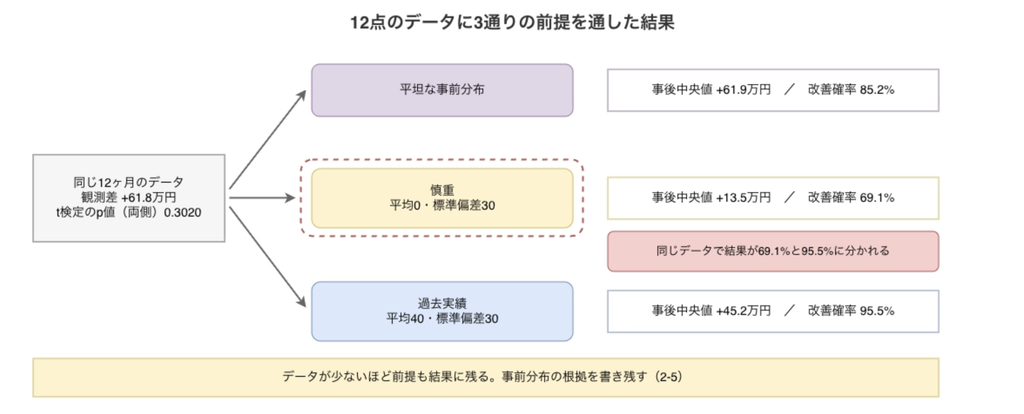
事前分布に情報を入れると、結果は変わります。同じ12点のデータでも、慎重な前提では改善確率69.1%、過去実績を使った前提では95.5%になりました。少数データでは、観測値だけでなく、分析に持ち込んだ前提も結果に残ります。
ここから先は、事前分布の根拠をどう残すか、確率を金額の経営判断にどう変えるか、Claude Codeにどこまで任せるかを順に試します。PyMCのコードだけでなく、収束診断と感度分析まで同じ手順に入れました。1章から3章と4-3は手元で実行し、4章の残りは論文の報告と切り分けています。
なお、AI活用を見据えたデータの置き方とPoC評価については「AI時代の構造化データの置き方|情シスのためのガバナンスとPoC評価」もご参考ください。
少数データで何が起きるか|ベイズ推論と有意差なしの距離
有意差なしは効果なしという意味ではない
施策の効果検証で使われるt検定から見ます。施策前後6ヶ月ずつの月次売上を合成し、真の効果を+60万円、月ごとのばらつき(標準偏差)を90万円に設定しました。
このデータにt検定をかけると、次の結果になりました。
| 項目 | 値 |
|---|---|
| 観測された差 | +61.8万円 |
| t値 | 1.0884 |
| p値(両側) | 0.3020 |
| 95%信頼区間 | −64.7万円 から 188.3万円 |
観測差は真の効果に近い+61.8万円ですが、p値は0.3020で、有意水準5%では有意差なしです。p値は「効果がない」と仮定したときに今回以上に極端なデータが出る確率であり、施策を続けた場合の損得には直接答えません。
なお、実データの前後比較には季節性や他施策も入ります。ベイズ推論に替えても因果関係は生まれないため、以下は合成データとこのモデルを前提にした例です。
手法を変えても数字が変わらない場合
同じデータに対し、効果の特定の範囲を優先しない比較用の平坦な事前分布でベイズ推論を回しました。結果を並べます。
| 手法 | 中心の推定値 | 区間 | 改善している確率 |
|---|---|---|---|
| t検定 | +61.8万円 | 95%信頼区間 −64.7 から 188.3 | 1−片側p値 = 0.8490 |
| ベイズ推論(平坦な事前分布) | +61.9万円 | 95%信用区間 −62.4 から 192.9 | P(効果>0) = 0.8516 |
区間も確率もほぼ一致し、差はMCMC(乱数で事後分布を近似する計算。詳しくは6章)の計算誤差の範囲です。表ではt検定の信頼区間とベイズ推論の信用区間を書き分けていますが、平坦な事前分布のもとでは言い換えだけで判断材料は増えません(用語の違いは6章参照)。
2026年8月公開のベイズA/Bテストの整理論文(査読前)は、平坦な事前分布と正規近似の条件下で、P(B>A)>0.95と片側p値<0.05は代数的に同値だと述べています。両側p値ではないため、上表の0.8490も片側p値から求めました。
同論文のSetting A(各群最大5,000件、50件ごとに判定、10,000試行)では、結果が出るたびにp値で判定する素朴な途中停止と、平坦な事前分布でP(B>A)>0.95を使う方法の偽陽性率は、ともに0.303でした。
補足: ベイズ推論とt検定がいつでも一致する、という意味ではありません。モデルや事前分布、分散の扱いが変われば結果も変わります。
事前分布を入れると、数字はどれくらい動くか
では、事前分布に情報を入れるとどうなるか。同じ12点のデータに対し、2つの立場で事前分布を置きました。
- 慎重な立場: 過去の施策は成果のばらつきが大きく、効果は±30万円程度に収まっていた。効果の事前分布を平均0・標準偏差30の正規分布にする
- 過去の実績に基づく立場: 同種の販促を過去に数回実施し、平均+40万円・ばらつき30万円だった。事前分布を平均40・標準偏差30の正規分布にする
結果は次のとおりです。
| 効果の事前分布 | 事後中央値 | 95%信用区間 | 改善している確率 |
|---|---|---|---|
| 平坦 | +61.9万円 | −62.4 から 192.9 | 0.8516 |
| 平均0・標準偏差30 | +13.5万円 | −39.5 から 65.2 | 0.6911 |
| 平均40・標準偏差30 | +45.2万円 | −7.3 から 95.9 | 0.9554 |
同じデータでも、改善確率は69.1%と95.5%、事後中央値は+13.5万円と+45.2万円に分かれました。データが少ないため、事前に置いた情報が事後分布(効果がいくらであるかの確からしさの分布)に強く残った結果です。
患者28人を扱った2025年の生存解析(生存期間の長さを扱う統計手法)研究でも、事前分布によりハザード比の95%信用区間の下限が0.989から1.016の範囲で動きました。しきい値の1をまたぐため、事前分布ごとの併記が欠かせません(詳細は4-2)。2章では、その根拠と感度を残す手順を実装します。
実装のステップ|Claude CodeにPyMCのモデルを書かせて判断を出す
完成すると何ができるか
1本のスクリプトで次の4つを出します。
- 施策効果の事後分布と95%信用区間
- 改善している確率と、収束診断の指標(R-hat、有効サンプル数(ESS)、発散回数)
- 事前分布を変えたときに結論がどこまで動くかの感度分析
- 確率を金額に変換した判断材料(継続と中止それぞれの期待後悔)
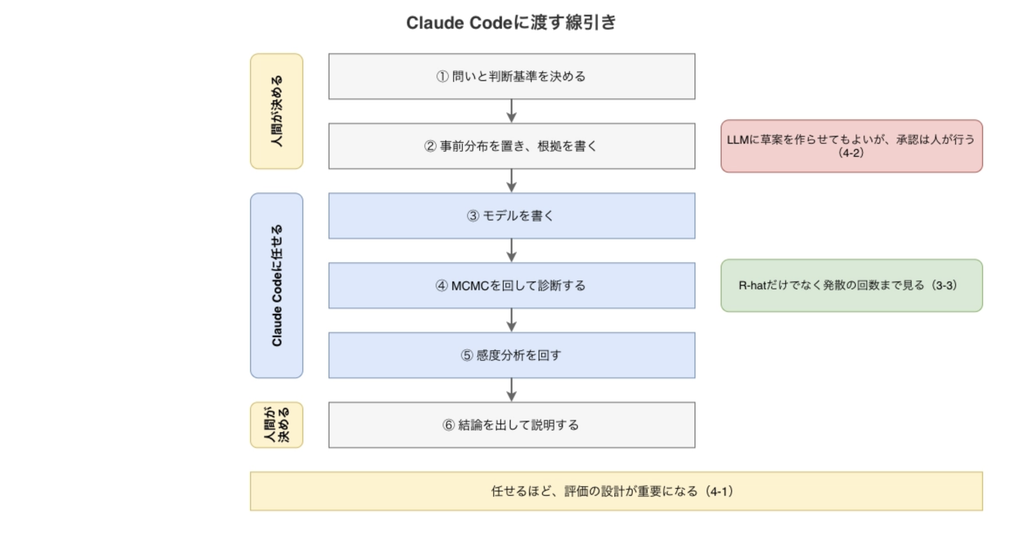
Claude Codeにはモデル、診断コード、感度分析を書かせます。事前分布とその根拠は人間が決めます(詳しくは4章)。
なお、Claude Codeにコードを書かせて作成から修正までを完結させる進め方については「DifyのワークフローはYAMLで書ける Claude Codeで作成・修正・管理を完結させる実践ガイド」もご参考ください。

環境を用意する
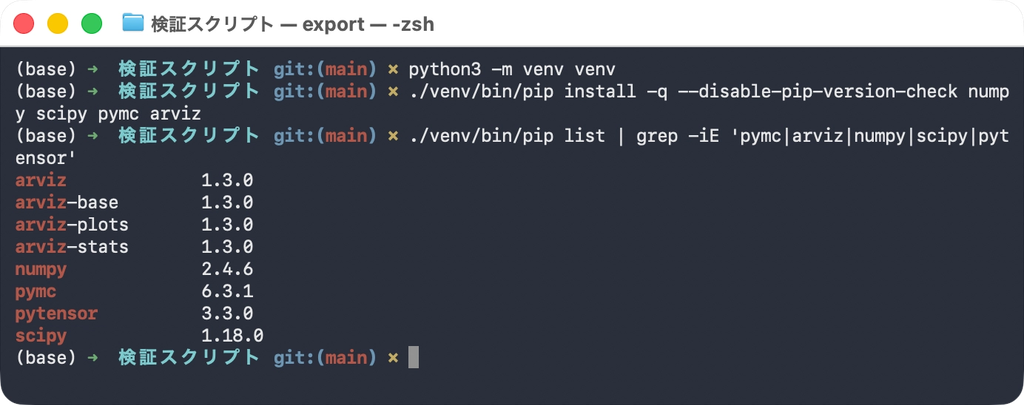
Pythonの仮想環境を作り、PyMCの使い方を試せるライブラリを入れます。
# 仮想環境を作る
python3 -m venv venv

# ベイズ推論とt検定に必要なライブラリを入れる
./venv/bin/pip install -q --disable-pip-version-check numpy scipy pymc arviz

# 入ったバージョンを確認する
./venv/bin/pip list | grep -iE 'pymc|arviz|numpy|scipy|pytensor'
PyMCはベイズモデルとMCMC、ArviZは収束診断に使います。今回の規模ではGPUは不要です。
Claude Codeの導入から実務活用までを体系的に把握したい方は「Claude Code完全入門:インストールから実務活用まで、AIコーディングの新常識を徹底解説」もご参考ください。
データを作り、まずt検定を通す
bayes_kpi.py を作り、合成データの生成とt検定までを書きます。2章と4-3のコードブロックは、すべてこのファイルの続きです(全文は7章の付録に載せました)。
import numpy as np                  # 数値計算
import scipy.stats as st            # t検定
import pymc as pm                   # ベイズモデルの記述とMCMC
import arviz as az                  # 収束診断

# 施策前6ヶ月・施策後6ヶ月の月次売上(万円)を合成する
# 真の効果は+60万円、月ごとのばらつきは標準偏差90万円に設定した
rng = np.random.default_rng(4)
pre = rng.normal(1200, 90, 6)       # 施策前6ヶ月
post = rng.normal(1260, 90, 6)      # 施策後6ヶ月
print("施策前:", np.round(pre, 1))
print("施策後:", np.round(post, 1))
print("観測された差: %.1f 万円" % (post.mean() - pre.mean()))

# 対応のないt検定(等分散を仮定)
t, p = st.ttest_ind(post, pre, equal_var=True)
print("t=%.4f  p値(両側)=%.4f  片側p値=%.4f  1-片側p値=%.4f" % (t, p, p / 2, 1 - p / 2))
実行結果は次のとおりです。
施策前: [1141.3 1184.3 1349.7 1259.3 1052.3 1199.5]
施策後: [1203.9 1273.4 1115.3 1281.8 1281.2 1401.8]
観測された差: 61.8 万円
t=1.0884  p値(両側)=0.3020  片側p値=0.1510  1-片側p値=0.8490
事前分布だけを差し替えられる形でモデルを書く
効果の事前分布だけを引数で差し替えられる形にすると、後の感度分析を同じコードで回せます。
このモデルは、Claude Codeに次の依頼を出して書かせました。
2-3で作った pre / post(各6点の月次売上、万円)について、施策の効果 delta を推定する
PyMCのスクリプトを書いてください。条件は次のとおりです。

- delta の事前分布だけを引数で差し替えられる関数 fit(delta_prior) にする
- 施策前の水準 mu と、ばらつきの対数 log_sigma には平坦な事前分布を置く
- 出力は事後中央値・95%信用区間・P(効果>0)・R-hat・ESS・発散回数を1行にまとめる
- 乱数の種は 20260819 に固定し、4チェーン・tune 2000・draw 5000 で回す
- 平坦な事前分布のとき、2-3で出した 1-片側p値 0.8490 と P(効果>0) が一致するかを
  自分で確認し、一致しなければモデルを直してから提出してください
最後の1行で、0.8490という照合値を渡しています。生成後の確認条件まで依頼に含める方法は、4-1の研究で評価指標を反復に使う考え方とも共通します。
出てきたコードが次のものです。
def fit(delta_prior):
    """効果deltaの事前分布を差し替えてMCMCを回し、事後分布を返す"""
    with pm.Model():
        mu = pm.Flat("mu", initval=1200.0)                      # 施策前の水準。平坦な事前分布
        delta = delta_prior("delta")                            # 施策の効果。ここだけ差し替える
        log_sigma = pm.Flat("log_sigma", initval=np.log(90.0))  # ばらつきの対数に平坦な事前分布
        sigma = pm.Deterministic("sigma", pm.math.exp(log_sigma))
        pm.Normal("y_pre", mu, sigma, observed=pre)             # 施策前の観測モデル
        pm.Normal("y_post", mu + delta, sigma, observed=post)   # 施策後は水準がdeltaだけ動く
        idata = pm.sample(5000, tune=2000, chains=4, random_seed=20260819,
                          progressbar=False, compute_convergence_checks=False)
    return idata


def report(name, idata):
    """事後中央値・95%信用区間・改善確率・収束診断を1行で出す"""
    d = idata.posterior["delta"].values.reshape(-1)
    lo, hi = np.percentile(d, [2.5, 97.5])
    divergences = int(idata.sample_stats["diverging"].values.sum())
    print("%-22s 中央値=%6.1f  95%%信用区間=[%6.1f, %6.1f]  P(効果>0)=%.4f  R-hat=%.4f  ESS=%.0f  発散=%d"
          % (name, np.median(d), lo, hi, (d > 0).mean(),
             float(az.rhat(idata)["delta"].values), float(az.ess(idata)["delta"].values),
             divergences))
    return d


# 平坦な事前分布。頻度論の結果と一致するかを確かめる
d_flat = report("平坦事前", fit(lambda n: pm.Flat(n, initval=0.0)))

# 情報を入れた事前分布。2通りの立場で置く
d_care = report("慎重 Normal(0,30)", fit(lambda n: pm.Normal(n, mu=0.0, sigma=30.0)))
d_past = report("過去実績 Normal(40,30)", fit(lambda n: pm.Normal(n, mu=40.0, sigma=30.0)))
log_sigma の平坦な事前分布は、sigma では1/sigmaに比例し、積分して1にならない不適切事前分布です。t検定に近い結果を再現する比較用であり、「前提なし」という意味ではありません。
実行結果は次のようになります。
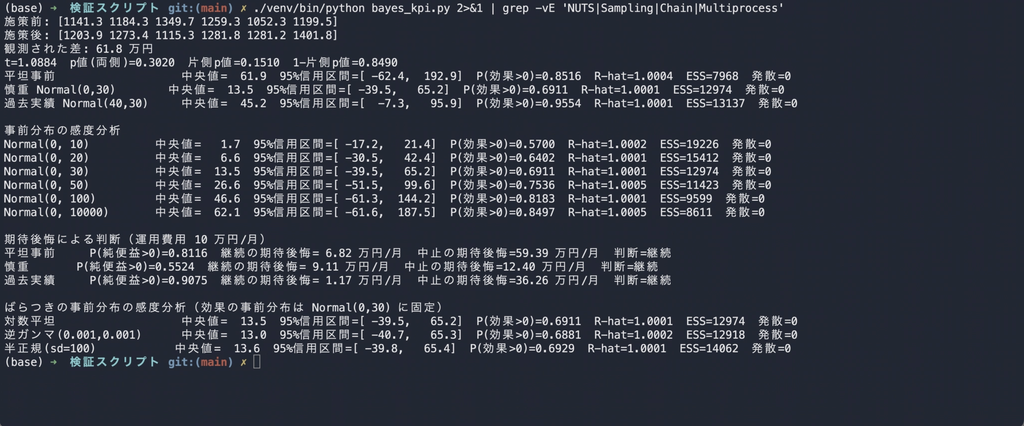
平坦事前                   中央値=  61.9  95%信用区間=[ -62.4,  192.9]  P(効果>0)=0.8516  R-hat=1.0004  ESS=7968  発散=0
慎重 Normal(0,30)        中央値=  13.5  95%信用区間=[ -39.5,   65.2]  P(効果>0)=0.6911  R-hat=1.0001  ESS=12974  発散=0
過去実績 Normal(40,30)     中央値=  45.2  95%信用区間=[  -7.3,   95.9]  P(効果>0)=0.9554  R-hat=1.0001  ESS=13137  発散=0
3モデルとも発散0回で、R-hat(計算が安定したかの指標)とESS(実質的に使える標本数)にも異常はありませんでした。R-hatが1.01を超えた結果は採用せず、原因を調べます。収束とは別に、事後予測チェックによる当てはまりの確認も必要です。
事前分布を変えて判断の境目を見る
事前分布に唯一の正解はありません。幅を変えて同じモデルを回し、結論がどこまで動くかを示します。
# 事前分布の幅を変えて、結論がどこまで動くかを見る
print("\n事前分布の感度分析")
for s in [10, 20, 30, 50, 100, 10000]:
    report("Normal(0, %d)" % s, fit(lambda n, s=s: pm.Normal(n, mu=0.0, sigma=float(s))))
実行結果です。
Normal(0, 10)          中央値=   1.7  95%信用区間=[ -17.2,   21.4]  P(効果>0)=0.5700  R-hat=1.0002  ESS=19226  発散=0
Normal(0, 20)          中央値=   6.6  95%信用区間=[ -30.5,   42.4]  P(効果>0)=0.6402  R-hat=1.0001  ESS=15412  発散=0
Normal(0, 30)          中央値=  13.5  95%信用区間=[ -39.5,   65.2]  P(効果>0)=0.6911  R-hat=1.0001  ESS=12974  発散=0
Normal(0, 50)          中央値=  26.6  95%信用区間=[ -51.5,   99.6]  P(効果>0)=0.7536  R-hat=1.0005  ESS=11423  発散=0
Normal(0, 100)         中央値=  46.6  95%信用区間=[ -61.3,  144.2]  P(効果>0)=0.8183  R-hat=1.0001  ESS=9599  発散=0
Normal(0, 10000)       中央値=  62.1  95%信用区間=[ -61.6,  187.5]  P(効果>0)=0.8497  R-hat=1.0005  ESS=8611  発散=0
同じ結果を表にまとめます。
| 効果の事前分布 | 事後中央値 | 95%信用区間 | 改善している確率 |
|---|---|---|---|
| 平均0・標準偏差10 | +1.7万円 | −17.2 から 21.4 | 0.5700 |
| 平均0・標準偏差20 | +6.6万円 | −30.5 から 42.4 | 0.6402 |
| 平均0・標準偏差30 | +13.5万円 | −39.5 から 65.2 | 0.6911 |
| 平均0・標準偏差50 | +26.6万円 | −51.5 から 99.6 | 0.7536 |
| 平均0・標準偏差100 | +46.6万円 | −61.3 から 144.2 | 0.8183 |
| 平均0・標準偏差10,000 | +62.1万円 | −61.6 から 187.5 | 0.8497 |
改善確率は57.0%から85.0%まで動き、標準偏差10,000では平坦な事前分布の0.8516にほぼ戻ります。ただし、この幅は現実的でないほど大きな効果にも確率を割り当てるため、「広いほど中立」とは限りません。表と事前分布の根拠を一緒に保存します。
確率を金額の判断に変える
改善確率だけでは継続か中止かを決められません。選ばなかったほうが得だった金額を後悔と定義し、その期待値を比べます。
# 効果から運用費用を引いた純便益で判断する
COST = 10.0                                # 施策を1ヶ月続ける運用費用(万円)
print("\n期待後悔による判断(運用費用 %.0f 万円/月)" % COST)
for name, d in [("平坦事前", d_flat), ("慎重", d_care), ("過去実績", d_past)]:
    net = d - COST                              # 施策効果から運用費用を引いた純便益
    regret_keep = np.maximum(-net, 0).mean()    # 継続を選んだときの期待後悔
    regret_stop = np.maximum(net, 0).mean()     # 中止を選んだときの期待後悔
    print("%-8s P(純便益>0)=%.4f  継続の期待後悔=%5.2f 万円/月  中止の期待後悔=%5.2f 万円/月  判断=%s"
          % (name, (net > 0).mean(), regret_keep, regret_stop,
             "継続" if regret_keep < regret_stop else "中止"))
実行結果は次のとおりです。
期待後悔による判断(運用費用 10 万円/月)
平坦事前     P(純便益>0)=0.8116  継続の期待後悔= 6.82 万円/月  中止の期待後悔=59.39 万円/月  判断=継続
慎重       P(純便益>0)=0.5524  継続の期待後悔= 9.11 万円/月  中止の期待後悔=12.40 万円/月  判断=継続
過去実績     P(純便益>0)=0.9075  継続の期待後悔= 1.17 万円/月  中止の期待後悔=36.26 万円/月  判断=継続
同じ出力を表に整理します。
| 効果の事前分布 | P(純便益>0) | 継続の期待後悔 | 中止の期待後悔 | 判断 |
|---|---|---|---|---|
| 平坦事前 | 0.8116 | 6.82万円/月 | 59.39万円/月 | 継続 |
| 慎重(平均0・標準偏差30) | 0.5524 | 9.11万円/月 | 12.40万円/月 | 継続 |
| 過去実績(平均40・標準偏差30) | 0.9075 | 1.17万円/月 | 36.26万円/月 | 継続 |
月10万円の運用費を引くと、純便益がプラスになる確率は0.5524から0.9075まで開きますが、3通りとも継続です。
慎重な事前分布では期待後悔の差が月3.29万円で、運用費があと4万円高ければ中止に変わります。確認すべきなのは69.1%の印象ではなく、自社の費用と損失を入れた判断の境目です。
先のA/Bテスト論文のSetting Aでは、期待損失による途中停止(ε=0.02)の偽陽性率は0.499でした。ベイズ因子による停止は、効果量の事前標準偏差をMDE(検出したい最小効果)と等しくした条件で0.019、2倍に広げた条件で0.016です。この記事の期待後悔は、途中停止ではなくデータ取得後の行動選択にだけ使います。
補足: 運用費10万円は例です。人件費、広告費、ツール利用料だけでなく、解約のしにくさや機会損失も必要に応じて含めます。後悔の式と入力値は、結果と一緒に示します。
【顔写真2:2章から3章への切り替え。キャプション案「ここまでは1店舗の話です。ここからは、データが足りない店舗が他店の数字をどこまで借りてよいかを見ていきます」】
応用例|他店舗のデータを借りる階層ベイズ
独立推定と完全プーリングの間を取る
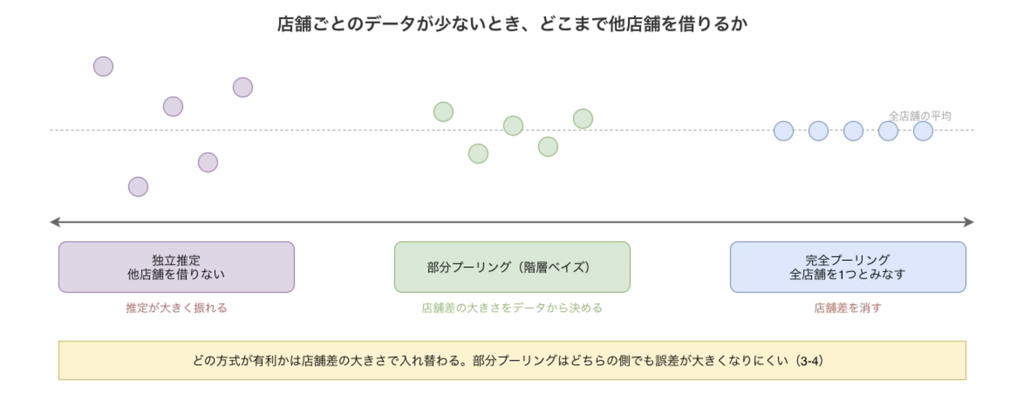
1店舗あたり12ヶ月ぶんしかない場合、推定方法は大きく3つあります。
| 方式 | 内容 | 弱点 |
|---|---|---|
| 独立推定 | 店舗ごとに、その店舗のデータだけで効果を推定する | 1店舗ぶんのデータが少なく、推定が大きく振れる |
| 完全プーリング | 全店舗をまとめて1つの効果として推定する | 店舗ごとの差を消してしまう |
| 部分プーリング(階層ベイズ) | 店舗ごとに推定しつつ、全体平均へ引き寄せる | 店舗差の大きさをデータから推定する必要がある |
階層ベイズは、店舗効果が共通の分布から生じたと考え、その分布の広さも推定します。 店舗差が小さければ全体平均へ強く寄せ、大きければ各店の観測値を多く残します。
5店舗の合成データで比べる
5店舗、各店舗で施策前後6ヶ月ずつのデータを作りました。店舗ごとの真の効果は平均+40万円・店舗差の標準偏差25万円、月次のばらつきは標準偏差90万円です。
import numpy as np                  # 数値計算
import pymc as pm                   # ベイズモデルの記述とMCMC
import arviz as az                  # 収束診断

J, N, SIGMA = 5, 6, 90.0            # 店舗数、施策前後それぞれの月数、月次のばらつき(万円)

# 5店舗ぶんの合成データ。店舗ごとの真の効果は平均+40万円、店舗差は標準偏差25万円
rng = np.random.default_rng(7)
true_delta = rng.normal(40.0, 25.0, J)              # 店舗ごとの真の効果
base = rng.normal(1200.0, 150.0, J)                 # 店舗ごとの元の売上水準
pre = rng.normal(base[:, None], SIGMA, (J, N))      # 施策前6ヶ月
post = rng.normal((base + true_delta)[:, None], SIGMA, (J, N))  # 施策後6ヶ月
obs = post.mean(1) - pre.mean(1)                    # 店舗ごとの観測差

def rmse(est):
    """真の効果からのずれ(二乗平均平方根誤差)"""
    return float(np.sqrt(np.mean((est - true_delta) ** 2)))

print("真の効果:", np.round(true_delta, 1))
print("観測差  :", np.round(obs, 1))
print("店舗ごとに独立に推定: RMSE=%.1f 万円" % rmse(obs))
print("全店舗を1つにまとめる: RMSE=%.1f 万円" % rmse(np.full(J, obs.mean())))
真の効果: [40. 47.5 33.1 17.7 28.6]
観測差 : [ 12.3 182. 120.6 65.3 9.7]
店舗ごとに独立に推定: RMSE=76.3 万円
全店舗を1つにまとめる: RMSE=45.7 万円真の効果は17.7万円から47.5万円ですが、観測差は9.7万円から182.0万円まで広がりました。乱数の種7で作った1回の合成例であり、一般的な振れ幅ではありません。
続いて階層ベイズを回します。
def hierarchical(noncentered):
    """階層ベイズ。noncentered=Trueで非中心化パラメータ化に切り替える"""
    with pm.Model():
        mu_d = pm.Normal("mu_d", 0.0, 100.0)        # 全店舗に共通する効果の平均
        tau = pm.HalfNormal("tau", 50.0)            # 店舗ごとのばらつき
        if noncentered:
            z = pm.Normal("z", 0.0, 1.0, shape=J)   # 標準正規から引いて後で伸ばす
            delta = pm.Deterministic("delta", mu_d + tau * z)
        else:
            delta = pm.Normal("delta", mu_d, tau, shape=J)  # 直接引く(中心化)
        sigma = pm.HalfNormal("sigma", 150.0)       # 月次のばらつき
        mu_j = pm.Normal("mu_j", 1200.0, 300.0, shape=J)    # 店舗ごとの元の水準
        pm.Normal("y_pre", mu_j[:, None], sigma, observed=pre)             # 施策前の観測モデル
        pm.Normal("y_post", (mu_j + delta)[:, None], sigma, observed=post)  # 施策後は水準がdeltaだけ動く
        idata = pm.sample(4000, tune=3000, chains=4, random_seed=20260819,
                          target_accept=0.9, progressbar=False,
                          compute_convergence_checks=False)
    d = idata.posterior["delta"].values.reshape(-1, J)
    print("階層ベイズ(%s): RMSE=%.1f 万円  発散=%d 回  R-hat最大=%.4f"
          % ("非中心化" if noncentered else "中心化", rmse(np.median(d, axis=0)),
             int(idata.sample_stats["diverging"].values.sum()),
             float(np.max(az.rhat(idata)["delta"].values))))
    return np.median(d, axis=0)

hierarchical(False)
est = hierarchical(True)
print("階層ベイズの推定値:", np.round(est, 1))
階層ベイズ(中心化): RMSE=48.4 万円 発散=593 回 R-hat最大=1.0014
階層ベイズ(非中心化): RMSE=48.7 万円 発散=16 回 R-hat最大=1.0006
階層ベイズの推定値: [ 46. 120.4 93.2 68.7 45.5]独立推定のRMSE 76.3万円に対し、非中心化した階層モデルは48.7万円でした。出力順に対応を示します。
| 店舗 | 1 | 2 | 3 | 4 | 5 |
|---|---|---|---|---|---|
| 観測差 | 12.3 | 182.0 | 120.6 | 65.3 | 9.7 |
| 階層ベイズの推定値 | 46.0 | 120.4 | 93.2 | 68.7 | 45.5 |
| 真の効果 | 40.0 | 47.5 | 33.1 | 17.7 | 28.6 |
店舗2は182.0万円から120.4万円へ、店舗5は9.7万円から45.5万円へ寄りました。RMSEを計算できるのは真値を知る合成実験だからで、実データでは別期間の予測性能などを使います。
16回まで減っても採用しない
中心化モデルの発散593回は、非中心化すると16回に減りました。店舗差 tau が小さい領域の尖った形を、標準正規分布の z と mu_d + tau * z に分けて探索しやすくした結果です。ただし16回でも解決ではありません。
R-hatはどちらも1.01未満なので、この指標だけでは見逃します。target_accept、事前分布、モデル構造を見直し、発散を解消してから採用します。したがって、以降の48.7万円も診断途中の参考値です。方式の比較は、次の2,000回の反復で行います。
店舗差の大きさで優劣が入れ替わる
今回の1回では、完全プーリングのRMSE 45.7万円が階層ベイズの48.7万円を下回りました。店舗差が小さいときは、全店をまとめたほうが誤差を抑えられます。
これが1回の乱数だけの現象かを確認するため、店舗差の大きさを変えて2,000回ずつ繰り返しました。
se2 = 2 * SIGMA ** 2 / N            # 1店舗あたりの観測差の分散

def shrink(o):
    """経験ベイズの縮小推定。店舗差をデータから見積もって全体平均へ寄せる"""
    tau2 = max(o.var(ddof=1) - se2, 1e-6)
    return o.mean() + (tau2 / (tau2 + se2)) * (o - o.mean())

print("店舗差 | 独立推定 | 完全プーリング | 部分プーリング   ※平均RMSE(万円)")
for tau in [10, 25, 50, 100]:
    r = np.random.default_rng(2026)
    a = []
    for _ in range(2000):
        td = r.normal(40.0, tau, J)                 # 真の効果
        o = r.normal(td, np.sqrt(se2))              # 観測差
        a.append([np.sqrt(np.mean((o - td) ** 2)),
                  np.sqrt(np.mean((np.full(J, o.mean()) - td) ** 2)),
                  np.sqrt(np.mean((shrink(o) - td) ** 2))])
    m = np.mean(a, axis=0)
    print("  %4.0f |   %5.1f  |     %5.1f      |     %5.1f" % (tau, m[0], m[1], m[2]))
店舗差 | 独立推定 | 完全プーリング | 部分プーリング ※平均RMSE(万円)
10 | 49.5 | 21.8 | 26.3
25 | 49.5 | 30.6 | 32.4
50 | 49.5 | 48.7 | 40.8
100 | 49.5 | 88.8 | 47.0補足: ここは2,000回のMCMCを避け、経験ベイズの式で縮小係数を求めています。全体平均へ縮小する点は共通しますが、完全ベイズと同じ推定法ではありません。
| 店舗差(真の標準偏差) | 独立推定 | 完全プーリング | 部分プーリング |
|---|---|---|---|
| 10万円 | 49.5万円 | 21.8万円 | 26.3万円 |
| 25万円 | 49.5万円 | 30.6万円 | 32.4万円 |
| 50万円 | 49.5万円 | 48.7万円 | 40.8万円 |
| 100万円 | 49.5万円 | 88.8万円 | 47.0万円 |
観測差の標準誤差は52.0万円です。結果は次の3点に分かれます。
- 店舗差10万円と25万円では完全プーリング、50万円と100万円では部分プーリングが最小で、境目は25万円から50万円のあいだです
- 完全プーリングは店舗差100万円で88.8万円となり、独立推定の49.5万円を上回ります
- 部分プーリングは4条件すべてで独立推定を下回り、最大でも47.0万円です
店舗差が分からない場合、今回の4条件では部分プーリングが独立推定を一度も上回りませんでした。ただし、他店の情報を借りてよいという交換可能性が前提です。商圏や規模が大きく違う店舗を同じ階層に入れると、偏りの原因になります。
ベイズ推論の自動化|Claude Codeに任せてよい範囲と人間が決める範囲
コードの反復改善は任せられるか
モデルの記述、診断、感度分析を自動反復した研究例を見ます。
2026年3月公開のAutoStan(査読前)は、CLIのコーディングエージェントにStanモデルを改善させる仕組みです。Claude Code v2.1.86とSonnet 4.6、56行の指示ファイル、データ説明、評価指標のNLPD(小さいほど予測が良い)で構成されています。
指示は、データ確認、モデル編集、評価、結果解釈を繰り返す内容です。候補には、3-3で使った非中心化パラメータ化のほか、事前分布、尤度、階層構造の見直しが入っています。
結果は次のとおりです。
| データセット | 初期のNLPD | 最良のNLPD | オラクル(真の生成過程) |
|---|---|---|---|
| 1D回帰(訓練68件) | 2.248 | 1.124(5回目の反復) | 0.944 |
| 1D回帰(訓練500件) | 2.159 | 1.226(11回目の反復) | 1.144 |
| 階層モデル(20群×40件) | 1.404 | 1.401(4回目の反復) | 1.404 |
右端は、合成データを生んだ真の仕組みを使うオラクルです。1D回帰2件は改善したもののオラクルには届きません。階層データでは1.401がオラクルの1.404を下回りましたが、著者は固定した評価データへの軽い過適合(その評価データだけに合わせ込みすぎて、ほかのデータでは精度が落ちること)と解釈し、交差検証(データを分け、評価用を入れ替えながら何度も確かめる方法)や評価データの入れ替えを挙げています。反復回数が増えるほど評価設計が重要です。
反復10ではR-hat 1.52を検知してコードを直しましたが、その修正が統計的に妥当かは別途判断が必要です。
事前分布までLLMに作らせる研究もある
1-3の生存解析研究は、ChatGPT・Gemini・Grokに医学文献を基にハザード比の事前分布を作らせ、放射線腫瘍医が評価しました。
| 事前分布の作り手 | ハザード比の中央値 | 95%信用区間 |
|---|---|---|
| Grok(無情報) | 2.761 | 0.989 から 10.396 |
| ChatGPT(情報あり) | 2.740 | 1.016 から 9.605 |
| Gemini(情報あり) | 2.680 | 1.001 から 9.410 |
| Grok(情報あり) | 2.710 | 0.997 から 9.366 |
著者らは、複数の材料と専門家確認が必要だと述べています。支持されるのはLLMによる草案作成までで、専門家の承認を省く根拠にはなりません。
任せてはいけない部分
まず、既定の事前分布を無情報とみなしてはいけません。2020年のチュートリアルは、小標本では事前分布の影響が大きく、極端に広い既定値が不安定な推定を招く場合を示しています。名前ではなく分布形と尺度を確認します。
今回の平均差モデルでは、ばらつきの事前分布だけを差し替えて確認しました。
def fit_sigma(sigma_prior):
    """ばらつきの事前分布だけを差し替える。効果の事前分布は慎重 Normal(0,30) に固定する"""
    with pm.Model():
        mu = pm.Flat("mu", initval=1200.0)                   # 施策前の水準。平坦な事前分布
        delta = pm.Normal("delta", mu=0.0, sigma=30.0)       # 効果の事前分布は固定
        sigma = sigma_prior()                                # ここだけ差し替える
        pm.Normal("y_pre", mu, sigma, observed=pre)          # 施策前の観測モデル
        pm.Normal("y_post", mu + delta, sigma, observed=post)  # 施策後は水準がdeltaだけ動く
        idata = pm.sample(5000, tune=2000, chains=4, random_seed=20260819,
                          progressbar=False, compute_convergence_checks=False)
    return idata


def s_jeffreys():
    """標準偏差の対数に平坦な参照事前分布"""
    log_sigma = pm.Flat("log_sigma", initval=np.log(90.0))
    return pm.Deterministic("sigma", pm.math.exp(log_sigma))


def s_invgamma():
    """分散に逆ガンマ分布(形状・尺度とも0.001)。統計ソフトでよく既定になる置き方"""
    var = pm.InverseGamma("sigma2", alpha=0.001, beta=0.001, initval=8100.0)
    return pm.Deterministic("sigma", pm.math.sqrt(var))


def s_halfnormal():
    """標準偏差に半正規分布(標準偏差100)"""
    return pm.HalfNormal("sigma", 100.0, initval=90.0)


# ばらつきの事前分布を替えても結論が動くかを確かめる
print("\nばらつきの事前分布の感度分析(効果の事前分布は Normal(0,30) に固定)")
for name, sp in [("対数平坦", s_jeffreys), ("逆ガンマ(0.001,0.001)", s_invgamma),
                 ("半正規(sd=100)", s_halfnormal)]:
    report(name, fit_sigma(sp))
ばらつきの事前分布の感度分析(効果の事前分布は Normal(0,30) に固定)
対数平坦 中央値= 13.5 95%信用区間=[ -39.5, 65.2] P(効果>0)=0.6911 R-hat=1.0001 ESS=12974 発散=0
逆ガンマ(0.001,0.001) 中央値= 13.0 95%信用区間=[ -40.7, 65.3] P(効果>0)=0.6881 R-hat=1.0002 ESS=12918 発散=0
半正規(sd=100) 中央値= 13.6 95%信用区間=[ -39.8, 65.4] P(効果>0)=0.6929 R-hat=1.0001 ESS=14062 発散=0改善確率は0.6881から0.6929で、幅は0.005未満です。今回は効果の事前分布のほうが結果を動かしましたが、分散パラメータが増えるモデルには一般化できません。
もう1つは、自然言語からPyMCコードを生成した2025年の研究(査読前)です。実験Iは事前分布だけ、実験IIは事前分布と尤度をLLMに作らせました。共通データの真値は切片2.5、傾き1.8、ばらつき15.0、標本数100件です。
| 推定の担当 | 切片(真値2.5) | 傾き(真値1.8) | ばらつき(真値15.0) |
|---|---|---|---|
| 実験I:人手で事前分布を指定 | 0.975(94% HDI −4.650 から 6.433) | 1.827 | 14.881 |
| 実験I:LLMが事前分布を指定 | 0.828(94% HDI −4.393 から 5.842) | 1.829 | 14.805 |
| 実験II:LLMが事前分布と尤度を指定 | 1.146(94% HDI −4.264 から 7.131) | 1.823 | 14.818 |
区間は原典の94% HDIです。傾きとばらつきは真値に近く、切片だけが離れましたが、人手指定も0.975なのでLLM固有のずれではありません。真の切片は3行ともHDI内です。コードが動くことと、必要な情報を推定できることは分けて評価します。
まとめと結論
ベイズ推論は、少数データから経営判断の正解を作り出す方法ではありません。今回の平坦な事前分布では、改善確率0.8516がt検定から求めた0.8490とほぼ一致しました。
情報を入れると改善確率は69.1%と95.5%に分かれますが、月10万円の運用費では3通りとも継続でした。効果検証の結果は、確率だけでなく判断が入れ替わる費用水準まで示します。
実務では、まず費用と損失を決め、次に事前分布と過去データの対応を記録します。そのうえで両方の前提を動かし、判断が入れ替わる水準を示します。次のチェックリストにまとめました。
Claude Codeにはモデル、診断、感度分析を任せられます。一方、効果の定義、店舗のまとめ方、費用の範囲は人が決めます。この線引きが、有意差なしの先へ議論を進める条件です。
導入前チェックリスト
自社の効果検証にベイズ推論を持ち込めるかを判断するための項目です。作業の完了確認ではなく、着手できるかどうかの材料として使ってください。
- 判断したい問いを、継続か中止かのように選択肢の形で書き出した
- 継続と中止それぞれの費用と損失を、月あたりの金額で置いた
- 事前分布の根拠に使える過去データ(同種施策の実績、他店舗の数値)があるか確認した
- 事前分布を複数置き、判断が入れ替わる費用水準まで示す前提で合意した
- 他店舗や他部門の数値を借りる場合、同じ集団として扱える根拠を説明できる
- R-hat・ESS・発散回数を毎回確認し、発散が残る結果は配らない運用にした
- 実データと合成データの違い(季節性、値上げ、他施策の影響)を洗い出した
- PyMCを動かすPython環境と、実行結果を保存する場所を決めた
検証環境:
- macOS 26.5.2、Python 3.14.5
- PyMC 6.3.1、ArviZ 1.3.0、NumPy 2.4.6、SciPy 1.18.0、PyTensor 3.3.0
- Claude Code 2.1.232
- 検証日: 2026年8月19日(画像4の再実行・再撮影は2026年8月25日。乱数の種を固定しているため数値は同一)
- 1章から3章と4-3の数値は、記事中のスクリプトを上記環境で実行した結果です。乱数の種を固定しているため、同じ環境なら同じ値を再現できます
- 使用したデータはすべて合成データです。実データでは、月次の季節変動や施策以外の要因を別途モデルに入れる必要があります
- 各ライブラリの最新の仕様は公式ドキュメントで確認してください
用語解説|本文で使った統計用語をまとめて確認する
本文を読み返すときに迷いやすい言葉を、この記事での使い方に絞って整理します。
なお、「p検定」という独立した検定名は通常使いません。t検定などの仮説検定を行い、その結果としてp値を確認する、という関係です。
| 用語 | この記事での意味 |
|---|---|
| 仮説検定 | 最初に「施策の効果はない」などの仮定を置き、観測データがその仮定とどの程度食い違うかを調べる手順です。 |
| t検定 | 2つのグループの平均に差があるかを調べる仮説検定です。この記事では、施策前6ヶ月と施策後6ヶ月の平均売上を比べています。 |
| p値 | 効果がないと仮定したときに、今回と同じか、それ以上に極端なデータが出る確率です。「効果がない確率」や「施策が失敗する確率」ではありません。 |
| 有意水準 | p値を判定するときに先に決める基準です。5%を使う場合は、p値が0.05を下回ると有意差ありと判断します。 |
| 偽陽性率 | 本当は効果がないのに、差があると判定してしまう割合です。1-2と2-6で引用した論文の0.303や0.499は、この割合を指します。 |
| 有意差なし | p値が有意水準を下回らなかった状態です。効果が存在しないと証明したわけではなく、今回のデータだけでは差を明確に示せなかった、という意味です。 |
| 95%信頼区間 | 同じ手順でデータ取得と区間計算を繰り返したとき、作られた区間の95%が真の値を含むように設計された範囲です。今回得た1つの区間に真の値が入る確率を直接表したものではありません。 |
| 標準誤差 | 同じ条件でデータを取り直したときに、平均や差の推定値がどれくらい振れるかを表す値です。3-4の52.0万円は、1店舗ぶんの観測差の標準誤差です。 |
| ベイズ推論 | 観測前に置いた前提と実際のデータを組み合わせ、知りたい値の確からしさを更新する方法です。この記事では施策効果がどの範囲にありそうかを分布で求めています。 |
| 事前分布 | データを見る前に、効果がどの程度ありそうかを表した分布です。過去の施策実績や現場知見を使う場合は、その根拠も記録します。 |
| 尤度 | ある効果を仮定したときに、手元のデータがどの程度生じやすいかを表します。事前分布と尤度を組み合わせると事後分布が得られます。 |
| 事後分布 | 事前分布をデータで更新した後の分布です。効果の中央値、信用区間、改善している確率などは、この分布から計算します。 |
| 95%信用区間 | モデルとデータを前提にすると、推定対象が95%の確率で含まれる範囲です。信頼区間と名前は似ていますが、意味は異なります。 |
| HDI(最高密度区間) | 事後分布のうち、密度の高い部分を指定した割合だけ含む区間です。4-3で引用したLLM-BIの表は、原典に合わせて94% HDIと表記しています。 |
| ハザード比 | 一方の群でその事象が起きる速さが、他方の何倍かを表す値です。1なら差がなく、1をまたぐ区間は差を言い切れません。1-3と4-2で引用した医療研究の単位です。 |
| MCMC | 事後分布を直接計算しにくいときに、乱数を使って多数の候補値を生成し、分布を近似する計算方法です。 |
| R-hat | 複数の計算系列が同じ分布に落ち着いたかを見る指標です。1に近いほど安定していますが、R-hatだけでモデルの妥当性までは判断できません。 |
| ESS | MCMCで得た値のうち、独立した情報として実質的に使える標本数です。見かけの取得数が多くても、値どうしの依存が強いとESSは小さくなります。 |
| 発散 | MCMCが事後分布の一部を正しく探索できなかった可能性を示す警告です。発散が残る場合は、その結果をそのまま実務判断に使いません。 |
| 事後予測チェック | 推定したモデルから架空のデータを作り、手元の実データと形が似ているかを見る確認です。計算が収束したかとは別に、モデルの当てはまりを見ます。 |
| 感度分析 | 事前分布や費用などの前提を変え、結論がどこで変わるかを確かめる作業です。前提に依存する判断を見つけやすくなります。 |
| 過適合 | 手元の評価データだけに合わせ込みすぎて、ほかのデータでは精度が落ちる状態です。4-1では、同じ評価データで反復改善を続けたときの注意点として出てきます。 |
| 交差検証 | データをいくつかに分け、評価用を入れ替えながら何度も確かめる方法です。1つの評価データへの過適合を見つけやすくなります。 |
| 純便益 | 施策の効果から運用費用を引いた金額です。2-6では、月10万円を引いた後にプラスとなる確率を求めています。 |
| 期待後悔 | ある行動を選んだ後で、別の行動のほうが得だった場合に失う金額の平均です。この記事では、継続と中止のどちらの期待後悔が小さいかを比べています。 |
| ベイズ因子 | 2つの仮説のどちらが手元のデータをよく説明するかを表す比です。2-6では、効果量の事前標準偏差をMDEと等しく置いた条件で、これを使った停止規則の偽陽性率0.019を引用しています。 |
| 階層ベイズ | 店舗ごとの違いを残しながら、全店舗の情報も一部共有して推定するモデルです。データの少ない店舗ほど、全体の傾向を強く参照します。 |
| 部分プーリング | 店舗を完全に別々に扱う方法と、すべて同じとみなす方法の中間です。どの程度全体平均へ寄せるかをデータから決めます。 |
| 交換可能性 | 他店の情報を自店の推定に使ってよいとみなす仮定です。商圏や規模が大きく違う店舗を同じ階層に入れると、この仮定が崩れます。 |
| 経験ベイズ | 事前分布の形をデータ全体から見積もって使う方法です。3-4では、2,000回の繰り返しを軽く回すためにこの方法で縮小の度合いを求めています。 |
| RMSE | 推定値と正解のずれを二乗して平均し、平方根を取った値です。小さいほど推定誤差が小さいと読めます。この記事では、正解をあらかじめ設定した合成データの比較にだけ使っています。 |
付録|スクリプト全文
本文のコードブロックを、出てくる順に1つのファイルへまとめたものです。追記や省略はしていません。上から順に貼り付ければ、そのまま実行できます。実行環境は記事末尾の検証環境と同じです。
Windowsで動かす場合だけ、1か所の対応が必要です。PyMCが並列サンプリングに使うmultiprocessingの仕様で、スクリプト全体が読み直されるためです。スクリプト全体を if __name__ == "__main__": の中に入れるか、pm.sample(...) に cores=1 を足してください。どちらも数値は変わりません。
bayes_kpi.py(2章と4-3)
2-3のデータ生成とt検定、2-4のモデル、2-5の感度分析、2-6の期待後悔、4-3のばらつきの事前分布の感度分析を、この順に並べています。実行は ./venv/bin/python bayes_kpi.py です。
import numpy as np                  # 数値計算
import scipy.stats as st            # t検定
import pymc as pm                   # ベイズモデルの記述とMCMC
import arviz as az                  # 収束診断

# 施策前6ヶ月・施策後6ヶ月の月次売上(万円)を合成する
# 真の効果は+60万円、月ごとのばらつきは標準偏差90万円に設定した
rng = np.random.default_rng(4)
pre = rng.normal(1200, 90, 6)       # 施策前6ヶ月
post = rng.normal(1260, 90, 6)      # 施策後6ヶ月
print("施策前:", np.round(pre, 1))
print("施策後:", np.round(post, 1))
print("観測された差: %.1f 万円" % (post.mean() - pre.mean()))

# 対応のないt検定(等分散を仮定)
t, p = st.ttest_ind(post, pre, equal_var=True)
print("t=%.4f  p値(両側)=%.4f  片側p値=%.4f  1-片側p値=%.4f" % (t, p, p / 2, 1 - p / 2))

def fit(delta_prior):
    """効果deltaの事前分布を差し替えてMCMCを回し、事後分布を返す"""
    with pm.Model():
        mu = pm.Flat("mu", initval=1200.0)                      # 施策前の水準。平坦な事前分布
        delta = delta_prior("delta")                            # 施策の効果。ここだけ差し替える
        log_sigma = pm.Flat("log_sigma", initval=np.log(90.0))  # ばらつきの対数に平坦な事前分布
        sigma = pm.Deterministic("sigma", pm.math.exp(log_sigma))
        pm.Normal("y_pre", mu, sigma, observed=pre)             # 施策前の観測モデル
        pm.Normal("y_post", mu + delta, sigma, observed=post)   # 施策後は水準がdeltaだけ動く
        idata = pm.sample(5000, tune=2000, chains=4, random_seed=20260819,
                          progressbar=False, compute_convergence_checks=False)
    return idata


def report(name, idata):
    """事後中央値・95%信用区間・改善確率・収束診断を1行で出す"""
    d = idata.posterior["delta"].values.reshape(-1)
    lo, hi = np.percentile(d, [2.5, 97.5])
    divergences = int(idata.sample_stats["diverging"].values.sum())
    print("%-22s 中央値=%6.1f  95%%信用区間=[%6.1f, %6.1f]  P(効果>0)=%.4f  R-hat=%.4f  ESS=%.0f  発散=%d"
          % (name, np.median(d), lo, hi, (d > 0).mean(),
             float(az.rhat(idata)["delta"].values), float(az.ess(idata)["delta"].values),
             divergences))
    return d


# 平坦な事前分布。頻度論の結果と一致するかを確かめる
d_flat = report("平坦事前", fit(lambda n: pm.Flat(n, initval=0.0)))

# 情報を入れた事前分布。2通りの立場で置く
d_care = report("慎重 Normal(0,30)", fit(lambda n: pm.Normal(n, mu=0.0, sigma=30.0)))
d_past = report("過去実績 Normal(40,30)", fit(lambda n: pm.Normal(n, mu=40.0, sigma=30.0)))

# 事前分布の幅を変えて、結論がどこまで動くかを見る
print("\n事前分布の感度分析")
for s in [10, 20, 30, 50, 100, 10000]:
    report("Normal(0, %d)" % s, fit(lambda n, s=s: pm.Normal(n, mu=0.0, sigma=float(s))))

# 効果から運用費用を引いた純便益で判断する
COST = 10.0                                # 施策を1ヶ月続ける運用費用(万円)
print("\n期待後悔による判断(運用費用 %.0f 万円/月)" % COST)
for name, d in [("平坦事前", d_flat), ("慎重", d_care), ("過去実績", d_past)]:
    net = d - COST                              # 施策効果から運用費用を引いた純便益
    regret_keep = np.maximum(-net, 0).mean()    # 継続を選んだときの期待後悔
    regret_stop = np.maximum(net, 0).mean()     # 中止を選んだときの期待後悔
    print("%-8s P(純便益>0)=%.4f  継続の期待後悔=%5.2f 万円/月  中止の期待後悔=%5.2f 万円/月  判断=%s"
          % (name, (net > 0).mean(), regret_keep, regret_stop,
             "継続" if regret_keep < regret_stop else "中止"))

def fit_sigma(sigma_prior):
    """ばらつきの事前分布だけを差し替える。効果の事前分布は慎重 Normal(0,30) に固定する"""
    with pm.Model():
        mu = pm.Flat("mu", initval=1200.0)                   # 施策前の水準。平坦な事前分布
        delta = pm.Normal("delta", mu=0.0, sigma=30.0)       # 効果の事前分布は固定
        sigma = sigma_prior()                                # ここだけ差し替える
        pm.Normal("y_pre", mu, sigma, observed=pre)          # 施策前の観測モデル
        pm.Normal("y_post", mu + delta, sigma, observed=post)  # 施策後は水準がdeltaだけ動く
        idata = pm.sample(5000, tune=2000, chains=4, random_seed=20260819,
                          progressbar=False, compute_convergence_checks=False)
    return idata


def s_jeffreys():
    """標準偏差の対数に平坦な参照事前分布"""
    log_sigma = pm.Flat("log_sigma", initval=np.log(90.0))
    return pm.Deterministic("sigma", pm.math.exp(log_sigma))


def s_invgamma():
    """分散に逆ガンマ分布(形状・尺度とも0.001)。統計ソフトでよく既定になる置き方"""
    var = pm.InverseGamma("sigma2", alpha=0.001, beta=0.001, initval=8100.0)
    return pm.Deterministic("sigma", pm.math.sqrt(var))


def s_halfnormal():
    """標準偏差に半正規分布(標準偏差100)"""
    return pm.HalfNormal("sigma", 100.0, initval=90.0)


# ばらつきの事前分布を替えても結論が動くかを確かめる
print("\nばらつきの事前分布の感度分析(効果の事前分布は Normal(0,30) に固定)")
for name, sp in [("対数平坦", s_jeffreys), ("逆ガンマ(0.001,0.001)", s_invgamma),
                 ("半正規(sd=100)", s_halfnormal)]:
    report(name, fit_sigma(sp))
bayes_stores.py(3章)
3-2の合成データと階層モデル、3-4の繰り返し比較を並べています。実行は ./venv/bin/python bayes_stores.py です。中心化と非中心化の両方を回すため、完了まで手元の環境で1分ほどかかりました。
import numpy as np                  # 数値計算
import pymc as pm                   # ベイズモデルの記述とMCMC
import arviz as az                  # 収束診断

J, N, SIGMA = 5, 6, 90.0            # 店舗数、施策前後それぞれの月数、月次のばらつき(万円)

# 5店舗ぶんの合成データ。店舗ごとの真の効果は平均+40万円、店舗差は標準偏差25万円
rng = np.random.default_rng(7)
true_delta = rng.normal(40.0, 25.0, J)              # 店舗ごとの真の効果
base = rng.normal(1200.0, 150.0, J)                 # 店舗ごとの元の売上水準
pre = rng.normal(base[:, None], SIGMA, (J, N))      # 施策前6ヶ月
post = rng.normal((base + true_delta)[:, None], SIGMA, (J, N))  # 施策後6ヶ月
obs = post.mean(1) - pre.mean(1)                    # 店舗ごとの観測差

def rmse(est):
    """真の効果からのずれ(二乗平均平方根誤差)"""
    return float(np.sqrt(np.mean((est - true_delta) ** 2)))

print("真の効果:", np.round(true_delta, 1))
print("観測差  :", np.round(obs, 1))
print("店舗ごとに独立に推定: RMSE=%.1f 万円" % rmse(obs))
print("全店舗を1つにまとめる: RMSE=%.1f 万円" % rmse(np.full(J, obs.mean())))

def hierarchical(noncentered):
    """階層ベイズ。noncentered=Trueで非中心化パラメータ化に切り替える"""
    with pm.Model():
        mu_d = pm.Normal("mu_d", 0.0, 100.0)        # 全店舗に共通する効果の平均
        tau = pm.HalfNormal("tau", 50.0)            # 店舗ごとのばらつき
        if noncentered:
            z = pm.Normal("z", 0.0, 1.0, shape=J)   # 標準正規から引いて後で伸ばす
            delta = pm.Deterministic("delta", mu_d + tau * z)
        else:
            delta = pm.Normal("delta", mu_d, tau, shape=J)  # 直接引く(中心化)
        sigma = pm.HalfNormal("sigma", 150.0)       # 月次のばらつき
        mu_j = pm.Normal("mu_j", 1200.0, 300.0, shape=J)    # 店舗ごとの元の水準
        pm.Normal("y_pre", mu_j[:, None], sigma, observed=pre)             # 施策前の観測モデル
        pm.Normal("y_post", (mu_j + delta)[:, None], sigma, observed=post)  # 施策後は水準がdeltaだけ動く
        idata = pm.sample(4000, tune=3000, chains=4, random_seed=20260819,
                          target_accept=0.9, progressbar=False,
                          compute_convergence_checks=False)
    d = idata.posterior["delta"].values.reshape(-1, J)
    print("階層ベイズ(%s): RMSE=%.1f 万円  発散=%d 回  R-hat最大=%.4f"
          % ("非中心化" if noncentered else "中心化", rmse(np.median(d, axis=0)),
             int(idata.sample_stats["diverging"].values.sum()),
             float(np.max(az.rhat(idata)["delta"].values))))
    return np.median(d, axis=0)

hierarchical(False)
est = hierarchical(True)
print("階層ベイズの推定値:", np.round(est, 1))

se2 = 2 * SIGMA ** 2 / N            # 1店舗あたりの観測差の分散

def shrink(o):
    """経験ベイズの縮小推定。店舗差をデータから見積もって全体平均へ寄せる"""
    tau2 = max(o.var(ddof=1) - se2, 1e-6)
    return o.mean() + (tau2 / (tau2 + se2)) * (o - o.mean())

print("店舗差 | 独立推定 | 完全プーリング | 部分プーリング   ※平均RMSE(万円)")
for tau in [10, 25, 50, 100]:
    r = np.random.default_rng(2026)
    a = []
    for _ in range(2000):
        td = r.normal(40.0, tau, J)                 # 真の効果
        o = r.normal(td, np.sqrt(se2))              # 観測差
        a.append([np.sqrt(np.mean((o - td) ** 2)),
                  np.sqrt(np.mean((np.full(J, o.mean()) - td) ** 2)),
                  np.sqrt(np.mean((shrink(o) - td) ** 2))])
    m = np.mean(a, axis=0)
    print("  %4.0f |   %5.1f  |     %5.1f      |     %5.1f" % (tau, m[0], m[1], m[2]))
最後に
私たちは、単にシステムを組むだけの開発会社ではありません。低コストで高品質なAIツールの構築から、ROI(投資対効果)を最大化する導入ロードマップの策定、社内スタッフが自らAIを運用・改善できる体制の構築まで、AI導入の成功に必要なすべてを最初から最後まで丸ごと支援いたします。
実は、ご相談いただく方のほとんどが「何が分からないかも分からない」という状態からのスタートです。構想段階でも、ただのアイデアベースでも構いません。
まずは、あなたのお困りごとをそのまま聞かせていただけませんか?貴社のビジネスを加速させるパートナーとして伴走いたします。
無料オンライン相談で、最適な導入プランを相談する
参考文献
- Oliver Dürr「AutoStan: Autonomous Bayesian Model Improvement via Predictive Feedback」(2026年8月19日参照)
- Mårten Schultzberg、Mattias Frånberg「Bayesian Inference Procedures for A/B Testing: An Overview」(2026年8月19日参照)
- Richard Evans ほか「Large Language Model-Derived Priors Can Improve Bayesian Survival Analyses: A Glioblastoma Application」(2026年8月19日参照)
- Sanne C. Smid、Sonja D. Winter「Dangers of the Defaults: A Tutorial on the Impact of Default Priors When Using Bayesian SEM With Small Samples」(2026年8月19日参照)
- Yongchao Huang「LLM-BI: Towards Fully Automated Bayesian Inference with Large Language Models」(2026年8月19日参照)
- PyMC Developers「Diagnosing Biased Inference with Divergences」(2026年8月19日参照)
- ArviZ Developers「ArviZ 公式ドキュメント」(2026年8月19日参照)