ローカルLLMの企業運用に正解を出してみる
はじめに:Ollamaが動いた。その先の企業運用をどう判断するか
機密データを外部のAIに渡せない。それなら社内で動くローカルLLMを使おう。ここまでは話が早く、Ollamaも手元のPCですぐに動きました。困ったのはその先です。どのモデルなら、何人で、どの業務まで任せられるのか。企業運用へ進むための数字がありません。
そこで本記事では、費用、待ち時間、日本語での正確さを調べました。先行研究の数値と、Apple M5・メモリ24GBのMacで測った結果を分けて示します。
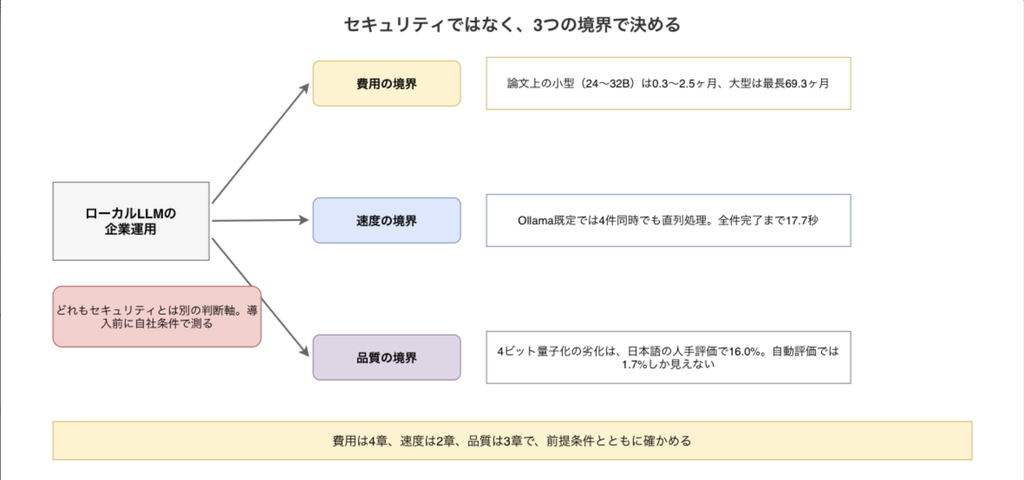
先に結論の数字を3つ出します。
- 費用:ある費用便益分析では、論文上の小型モデル(24〜32B)が0.3〜2.5ヶ月で商用APIとの損益分岐に達しました。ただし、機材を月8,600万トークン以上処理し続ける前提です。トークンは、LLMが文章を処理するときの単位です。月100万トークン程度なら、低価格帯APIの方が安くなる可能性が高まります
- 品質:4ビット量子化による日本語の性能低下は、自動評価では1.7%でも、人手評価では16.0%だったという報告があります。英語のベンチマークだけでは判断できません
- 速度:今回のMacでは、14Bモデルの生成速度は毎秒13.8トークンでした。Ollamaの既定設定で同時に4件を送ると、全件の完了まで17.7秒かかりました
1章でよくある前提を整理し、2章と3章で速度と日本語精度を測ります。4章では、その結果を費用計算と業務設計へつなげます。実測に使ったスクリプトとログは本文と付録に載せました。環境は記事末尾にまとめています。
なお、クラウド型のAIツールに機密情報を渡す際の設計については「Claude Code・Codexに機密情報を入れて大丈夫?情シスのためのセキュリティ設計ガイド」もご参考ください。ローカルLLMはこの記事の対策の代替ではなく、併用する選択肢の1つです。
基礎知識|ローカルLLM企業運用の3つの誤解
誤解1:ローカルならタダ同然で動く
自社の機材で動かせば、APIの従量課金は発生しません。一方で、機材、電力、保守、障害対応の費用は残ります。2025年8月にarXivで公開され同年11月に改訂された費用便益分析(査読前のプレプリント)は、オープンモデルを3つの規模帯に分け、必要なハードウェアと商用APIの単価から損益分岐点を計算しました。
| 規模帯 | 必要なハードウェアの例 | 商用APIに対する損益分岐 |
|---|---|---|
| 小型(24〜32B) | RTX 5090 1枚(2,000ドル) | 0.3〜2.5ヶ月 |
| 中型(70〜120B) | A100 2枚(15,000〜30,000ドル) | 2.3〜34ヶ月 |
| 大型(235B〜1T) | A100 4〜16枚(60,000〜240,000ドル) | 4.3〜69.3ヶ月 |
モデル規模のBは10億を表し、24Bなら約240億パラメータです。パラメータは、モデルが学習で調整した数値を指します。
前提は電力0.15ドル/kWh、稼働8時間/日×20日/月です。比較には、論文執筆時点のGPT-5(入力1.25ドル、出力10.00ドル/100万トークン)やClaude-4 Opus(同15.00ドル、75.00ドル)などのAPI単価が使われています。小型帯を毎秒150〜200トークンで160時間動かし続ける想定なので、月8,600万〜1億1,500万トークンに相当します。
ここでいう「小型」は24〜32Bです。2章で測る1.7B〜14Bより大きく、表の損益分岐を今回の3モデルへそのまま当てはめることはできません。0.3〜2.5ヶ月という短さも高い利用率と比較先のAPI単価によるものです。
補足: この分析には人件費と保守費が含まれていないと著者自身が明記しています。社内に運用担当を置くなら、損益分岐はこの表より後ろへずれます。
誤解2:大きいモデルを入れておけば安心
モデルを大きくすると品質が上がることは多いものの、同じ機材では生成が遅くなりやすく、必要なメモリも増えます。今回のMacでは、14Bモデルの生成速度は毎秒13.8トークンでした。Ollamaの既定設定で同じ依頼を4件同時に送ると、全件完了まで17.7秒かかりました(詳細は2章)。
1人での試用だけでは、社内展開後の待ち時間は分かりません。2026年1月にarXivで公開された中小企業向けの実測研究(査読前のプレプリント)では、ツールを繰り返し呼ぶエージェント型の負荷を64件同時にかけると、最初のトークンが出るまでRTX 5090で412ミリ秒、RTX 5060 Tiで37,077ミリ秒かかりました。一方、短い応答を返すAPI型の負荷では、同じRTX 5060 Ti・64件でも1秒未満です。待ち時間はモデルの大きさだけでなく、推論基盤、同時件数、処理内容をそろえて測る必要があります。
誤解3:量子化しても性能はほぼ同じ
ローカルLLMでは、量子化(モデル内部の数値を少ないビット数で表し、メモリと計算量を減らす圧縮)がよく使われます。今回Ollamaで取得した3モデルもQ4_K_Mという4ビット量子化版です。必要なメモリは減りますが、品質が同じとは限りません。
Cohereの研究チームが2024年に公開した多言語での量子化評価(査読を経てFindings of EMNLP 2024に採択)は、4ビット量子化の影響を自動評価と人手評価の両方で測りました。結果は次のとおりです。
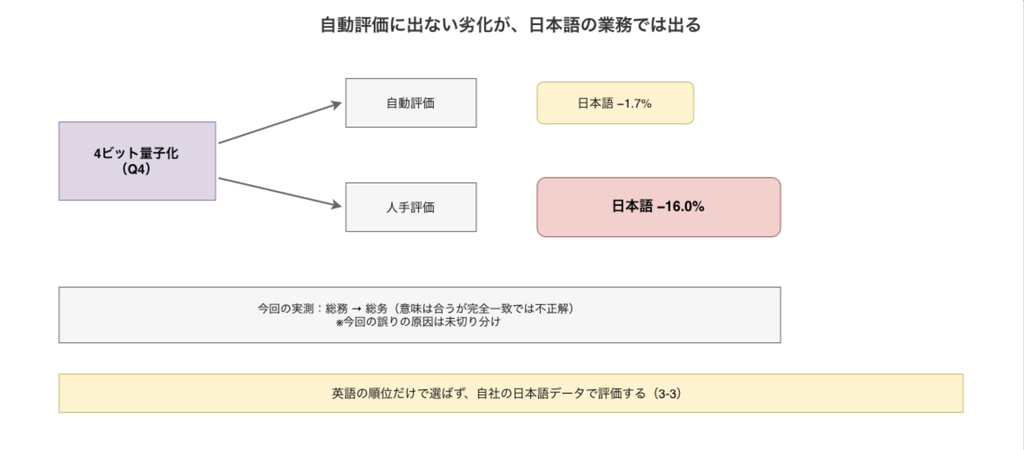
- 日本語は、自動評価の低下が1.7%なのに、人手評価では16.0%低下した。 自動指標は劣化を大幅に見逃す
- 非ラテン文字の言語ほど劣化が大きい。103Bモデルで、ラテン文字系の言語が0.7%の低下に対し、その他の言語は1.9%
- 課題別では数学的推論が13.1%と最も大きく落ちた
ただし、この研究が示すのは複数モデルを平均した傾向であり、すべてのQ4モデルが日本語で16.0%落ちるという意味ではありません。自社の業務でどの誤りが出るかは、実際の入力に近いテストで確かめる必要があります。3章では請求書の項目抽出と問い合わせ分類を使います。
実装のステップ|Ollamaで速度と同時アクセスを実測する
完成すると何ができるか
この章と次の章を終えると、自社で使う予定の機材について、次の3つの表が出せるようになります。
- モデル規模ごとの生成速度(トークン/秒)と1文字目までの待ち時間、メモリ使用量
- 同時アクセスしたときの待ち時間の伸び方
- 日本語の業務タスクでの正答率(3章)
スクリプトはPythonの標準ライブラリだけで動き、追加のインストールは不要です。本文には要点のブロックを載せ、全文は6章の付録に置きました。
環境を用意する
Ollama(ローカルLLMをHTTP API付きで動かすオープンソース)を入れ、規模の違う3つのモデルを取得します。
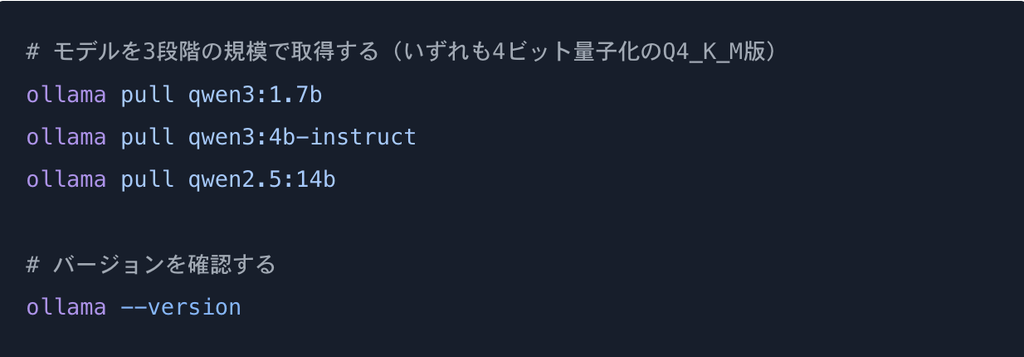
検証したのはOllama 0.32.5、機材はApple M5・メモリ24GBのMacです。専用のGPUサーバーではなく、ノートPC1台でどこまで動くかを確認しました。この結果はNVIDIA GPUや別の推論基盤へはそのまま当てはまりません。
補足: 3つのモデルはqwen3系(1.7B・4B)とqwen2.5系(14B)の混在です。同一系統で3規模をそろえられなかったため、規模の比較はあくまで目安として読んでください。系統の違いは3章の品質の結果で意味を持ちます。
単独アクセスの速度を測る
OllamaのAPIは、応答と一緒に計測値(読み込み時間・入力処理時間・生成トークン数・生成時間)を返します。次のコードでは、読み込み時間と入力処理時間の合計を「1文字目まで」と表示しています。stream: false なので画面上で1文字目を観測した値ではなく、生成開始前の内部処理時間を示す目安です。
import json                          # APIの入出力と結果の整形
import time                          # 実時間の計測
import urllib.request                # Ollamaへの HTTP リクエスト(標準ライブラリのみ)

URL = "http://localhost:11434/api/generate"        # OllamaのローカルAPI

def generate(model, num_predict=200):
    """1回生成し、Ollamaが返す計測値(ナノ秒)を取り出す"""
    body = {"model": model, "prompt": PROMPT, "stream": False,
            "options": {"temperature": 0, "num_predict": num_predict}}
    if model in THINKING:
        body["think"] = False                      # 思考の出力を止めて条件をそろえる
    req = urllib.request.Request(URL, json.dumps(body).encode(),
                                 {"Content-Type": "application/json"})
    t0 = time.time()
    r = json.load(urllib.request.urlopen(req, timeout=1200))
    r["wall"] = time.time() - t0                   # 依頼から完了までの実時間(秒)
    return r
プロンプトは、議事録を決定事項と宿題に分けて要約させる固定の日本語文です(全文は付録)。各モデルに3回ずつ依頼した結果がこちらです。
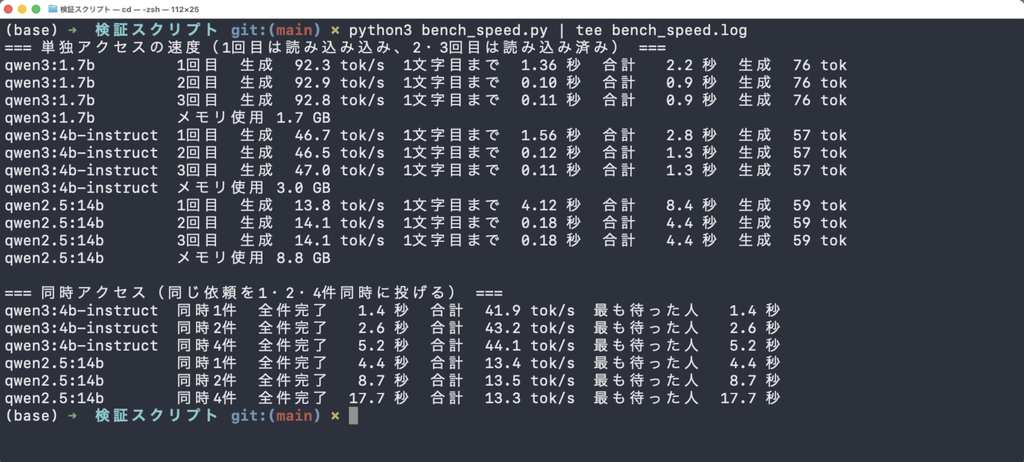
=== 単独アクセスの速度(1回目は読み込み込み、2・3回目は読み込み済み) ===
qwen3:1.7b         1回目  生成  92.3 tok/s  1文字目まで  1.36 秒  合計   2.2 秒  生成  76 tok
qwen3:1.7b         2回目  生成  92.9 tok/s  1文字目まで  0.10 秒  合計   0.9 秒  生成  76 tok
qwen3:1.7b         3回目  生成  92.8 tok/s  1文字目まで  0.11 秒  合計   0.9 秒  生成  76 tok
qwen3:1.7b         メモリ使用 1.7 GB
qwen3:4b-instruct  1回目  生成  46.7 tok/s  1文字目まで  1.56 秒  合計   2.8 秒  生成  57 tok
qwen3:4b-instruct  2回目  生成  46.5 tok/s  1文字目まで  0.12 秒  合計   1.3 秒  生成  57 tok
qwen3:4b-instruct  3回目  生成  47.0 tok/s  1文字目まで  0.11 秒  合計   1.3 秒  生成  57 tok
qwen3:4b-instruct  メモリ使用 3.0 GB
qwen2.5:14b        1回目  生成  13.8 tok/s  1文字目まで  4.12 秒  合計   8.4 秒  生成  59 tok
qwen2.5:14b        2回目  生成  14.1 tok/s  1文字目まで  0.18 秒  合計   4.4 秒  生成  59 tok
qwen2.5:14b        3回目  生成  14.1 tok/s  1文字目まで  0.18 秒  合計   4.4 秒  生成  59 tok
qwen2.5:14b        メモリ使用 8.8 GB
整理すると次のとおりです。
| モデル | 生成速度(読み込み済み) | 1文字目までの待ち | 初回(読み込み込み) | メモリ使用 |
|---|---|---|---|---|
| qwen3:1.7b | 毎秒92.3〜92.9トークン | 0.10〜0.11秒 | 1.36秒 | 1.7GB |
| qwen3:4b-instruct | 毎秒46.5〜47.0トークン | 0.11〜0.12秒 | 1.56秒 | 3.0GB |
| qwen2.5:14b | 毎秒13.8〜14.1トークン | 0.18秒 | 4.12秒 | 8.8GB |
文字数の違う2つの日本語文を読ませ、入力トークン数の差から換算すると、今回の3モデルはいずれも1トークンあたり約1.1文字でした。14Bは読み込み済みの状態で59トークンの要約を4.4秒で返しています。少なくとも今回の短い要約なら、1人で待つ時間としては許容できました。「14Bならどの業務でも実用的」という意味ではありません。
同時アクセスで何が起きるかを測る
企業運用で問題になるのはここからです。同じ依頼を1件・2件・4件同時に投げ、全員が受け取り終わるまでの時間を測りました。
import threading                     # 同時アクセスの再現

def bench_parallel(model, n):
    results = [None] * n
    errors = []
    def worker(k):
        try:
            results[k] = generate(model)
        except Exception as e:                     # 1件でも落ちたら測定値は使えない
            errors.append((k, e))
    generate(model, num_predict=8)                 # 読み込みを済ませてから測る
    t0 = time.time()
    threads = [threading.Thread(target=worker, args=(k,)) for k in range(n)]
    for t in threads: t.start()
    for t in threads: t.join()
    total = time.time() - t0
    if errors:                                     # 欠けたまま平均を出すと数字が良く見える
        raise RuntimeError("同時%d件のうち%d件が失敗: %s" % (n, len(errors), errors[0][1]))
    toks = sum(r["eval_count"] for r in results)
    walls = sorted(r["wall"] for r in results)
    print("%-18s 同時%d件  全件完了 %5.1f 秒  合計 %5.1f tok/s  最も待った人 %5.1f 秒"
          % (model, n, total, toks / total, walls[-1]))
=== 同時アクセス(同じ依頼を1・2・4件同時に投げる) ===
qwen3:4b-instruct 同時1件 全件完了 1.4 秒 合計 41.9 tok/s 最も待った人 1.4 秒
qwen3:4b-instruct 同時2件 全件完了 2.6 秒 合計 43.2 tok/s 最も待った人 2.6 秒
qwen3:4b-instruct 同時4件 全件完了 5.2 秒 合計 44.1 tok/s 最も待った人 5.2 秒
qwen2.5:14b 同時1件 全件完了 4.4 秒 合計 13.4 tok/s 最も待った人 4.4 秒
qwen2.5:14b 同時2件 全件完了 8.7 秒 合計 13.5 tok/s 最も待った人 8.7 秒
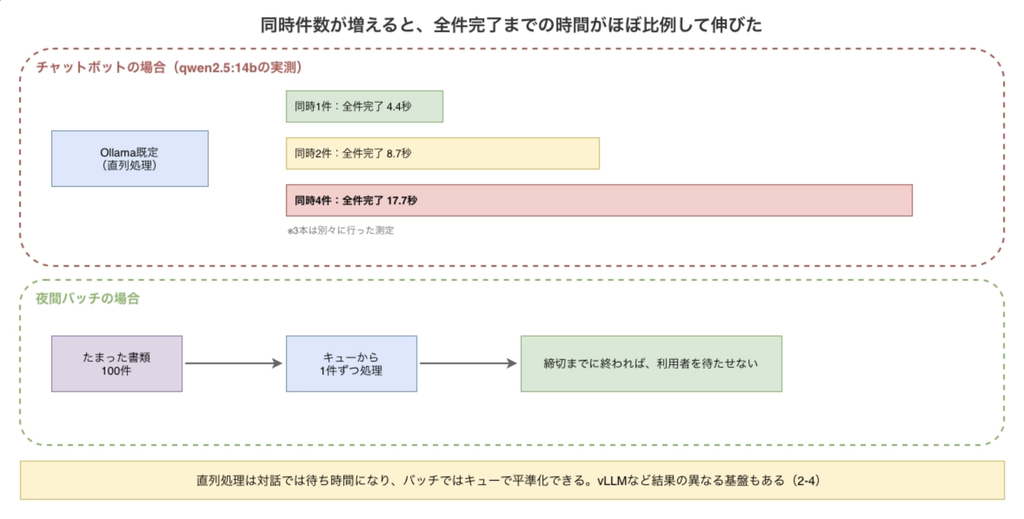
qwen2.5:14b 同時4件 全件完了 17.7 秒 合計 13.3 tok/s 最も待った人 17.7 秒今回の設定では、同時件数を1件、2件、4件と増やすと、全件完了までの時間もほぼ2倍ずつ伸びました。合計の生成速度は毎秒13〜14トークンのままで、同時処理による上積みはありません。4件のうち最も待った依頼は17.7秒で完了しています。
この直列処理はOllamaの既定値によるものです。公式ドキュメントは、1つのモデルが同時に処理する件数 OLLAMA_NUM_PARALLEL の既定を1と明記しています。増やすことはできますが、必要メモリが同時処理数に比例して増えます。
これはローカルLLM全般の性質ではありません。1-2で挙げた研究はvLLMという推論基盤を使っており、RTX 5090では同時32件で毎秒2,676トークン、64件で4,677トークン、128件で6,894トークンまで合計の処理量が増えています。複数の依頼をまとめて処理できる基盤では、同時件数を増やした方が機材を使い切れる場合があります。今回の結果は、24GBのMacでOllamaを既定のまま使った場合に限られます。
この違いは用途を選ぶ材料になります。対話では17.7秒の待ちがそのまま利用者の不満になりますが、締切までに処理すればよい夜間バッチなら、キューにためて順番に流せます。4章では、この前提で業務への組み込み方を考えます。
品質検証|ローカルLLMの日本語精度を業務タスクで測る
ワークフローの部品になる2つのタスクで測る
チャットの印象評価では線は引けないため、機械的に採点できる業務タスクを2つ用意しました。どちらも、後の章で扱う業務ワークフローの部品そのものです。
- 抽出(10問): 請求書風の文から会社名・請求日・請求金額の3項目をJSON(項目名と値を組にしたデータ形式)で抜き出す。和暦(令和8年)、漢数字(五十五万円)、小計と合計の混在、来月請求予定という引っかけを混ぜた
- 分類(10問): 社内の問い合わせ文を、経理・情シス・人事・総務の4つに振り分ける。カテゴリ名だけを出力させる
採点は温度0(出力のばらつきを抑える設定)で1回行い、抽出はフィールド単位30個、分類はカテゴリ名の完全一致で数えます。温度0でも実行環境によって出力が完全に同じになるとは限りません。問題文と採点コードの全文は付録にあります。
EX_PROMPT = ("次の文から会社名・請求日・請求金額を抜き出し、JSONだけを出力してください。"
             "キーは company・date・amount。dateはYYYY-MM-DD形式、amountは数値のみ。\n文:%s")

CL_PROMPT = ("次の社内問い合わせを、経理・情シス・人事・総務のどれか1つに振り分けてください。"
             "カテゴリ名だけを出力してください。\n問い合わせ:%s")
結果:抽出と分類で差が開いた
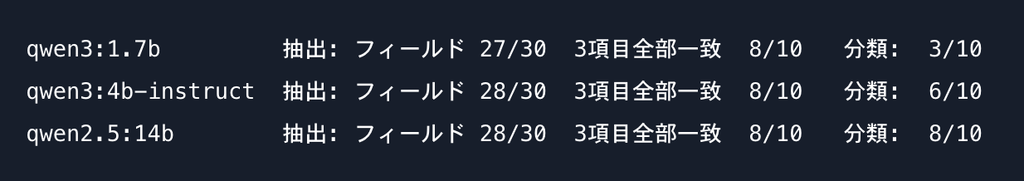
| モデル | 抽出(フィールド30個) | 抽出(3項目完全一致) | 分類(10問) |
|---|---|---|---|
| qwen3:1.7b | 27/30 | 8/10 | 3/10 |
| qwen3:4b-instruct | 28/30 | 8/10 | 6/10 |
| qwen2.5:14b | 28/30 | 8/10 | 8/10 |
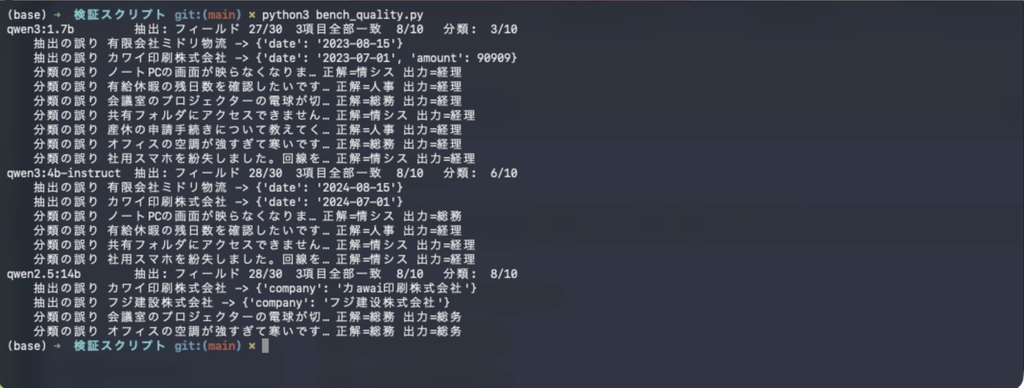
予想と逆でした。抽出は1.7Bでも27/30でしたが、分類は3/10です。しかも1.7Bは、10問すべてに「経理」と答えていました。正解した3問は、正解が経理だった問題です。3/10をそのまま「分類精度30%」と扱うのは適切ではなく、この出力では分類器として採用できません。
抽出は元の文にある値を写せます。分類では、「回線を止める依頼は情シス」といった対応づけが必要です。今回のプロンプトにカテゴリの定義や例は書かず、モデル側に判断を委ねました。平均点だけでなく、回答が1カテゴリに偏っていないかも確認すべきです。
誤りの中身には、規模より重要な情報が2つ含まれていました。
1つ目は和暦です。 「令和8年8月15日」を、1.7Bは2023年、4Bは2024年と誤変換しました。正しくは2026年で、正解したのは14Bだけです。西暦の日付は3モデルとも安定して通り、日付欄のある抽出10問で誤りが出たのは和暦の2問だけでした。母数が2問なので一般化はできませんが、請求書や行政文書のワークフローでは真っ先に確かめる箇所です。
2つ目は日本語の表記です。 14Bは、抽出で「フジ建设株式会社」(「設」が簡体字の「设」)と「カawai印刷株式会社」(「ワイ」がラテン文字に置換)、分類で「総务」(「務」が簡体字)と出力しました。分類先の意味は合っていても、完全一致で受け取るプログラムには別の文字列です。意味だけを採点する評価では見逃す可能性があります。なお、今回はQ4版しか測っていません。量子化で混入が増えたのか、モデル自体の傾向なのかは切り分けられていません。
補足: 1.7Bと4Bはqwen3、14Bはqwen2.5で、モデルの系統がそろっていません。また、1.7Bでは標準の思考出力を無効にしました。分類の差をパラメータ数だけの効果とは読めません。今回分かるのは、この3モデルをこの設定で動かした結果までです。
先行研究と今回の結果を照合する
今回見つかった表記の崩れと、量子化による品質低下を同じ原因だと断定することはできません。そのうえで、先行研究が示した注意点と照合します。
1-3で挙げたCohereの多言語量子化評価では、4ビット量子化による日本語の低下が自動評価で1.7%、人手評価で16.0%でした。今回の「総務」と「総务」の違いも、意味中心の評価と後段の完全一致で扱いが変わります。ただし、今回の誤りを量子化の影響とする根拠にはなりません。
日本語に限った報告もあります。2026年3月にarXivで公開された日本の技術基準QAでの検証(単一著者・査読前・評価100問)では、日本語データで追加学習したSwallow-8Bは、4ビット量子化の前後でスコア2.820から2.830とほぼ変わりませんでした。一方、Qwen2.5-7Bは2.420から2.140へ下がり、完全回答率も49%から30%に落ちました。 著者は、モデルが文章のどこを参照するかを計算するとき、一部の情報を複数の処理で共有して軽量化するGQAという構造が、量子化の誤差に弱いという仮説を挙げています。該当する系統では4ビットを避け、8ビット以上を使うよう推奨しています。
この報告には、今回の実測にとって都合の悪い部分があります。今回いちばん成績が良かったqwen2.5:14bは、報告が4ビットを避けるよう名指ししているQwen2.5系のQ4_K_M版そのものです。 著者は、メモリの都合で精度を落とすならQ8_0を使うか、Llama-3系のモデルを選ぶよう勧めています。今回の比較は3モデルともQ4での横並びで、同じモデルのQ8以上とは比べていません。14Bが良かったという結果は、Q4のなかで良かったという意味しかありません。Qwen系を4ビットで使うなら、Q8_0との比較を自社のテストで1回は通してください。
量子化の影響は、モデルの系統や言語、課題によって変わります。英語のリーダーボードとパラメータ数だけでは、Q4量子化したモデルの日本語精度は決められません。導入前に、自社の入力と正解をそろえた評価セットを作る必要があります。
今回の10問は、候補をふるいにかけるための小さなテストです。6/10と8/10の差だけで順位は決められません。本番候補を比べる段階では、実際の業務の内訳に合わせて件数を増やし、正答率だけでなく誤りの種類と再実行時のばらつきも記録します。100問程度を最初の目安にしても、業務の種類が偏っていれば追加が必要です。
企業運用の設計|チャットボットで終わらせず業務ワークフローに組み込む
チャットボットとワークフローでは、要件がまるで違う
ローカルLLMの検討は社内チャットボットから始まりがちです。ただ、今回のようにOllamaを既定設定で1台のMacに載せるなら、対話用途の方がバッチ処理より待ち時間の条件は厳しくなります。バッチ処理とは、たまった依頼を人が待たない時間帯にまとめて流す方法です。
| 観点 | 社内チャットボット | 業務ワークフロー(バッチ処理) |
|---|---|---|
| 同時アクセス | 利用が集中すると、その場で待ち時間が発生する | 利用者の同時要求はキューで平準化できる |
| 待ち時間の要求 | 人が待てる時間内に返す必要がある | 業務ごとに決めた締切までに終わればよい |
| 利用量 | 予測しにくく、費用計算が立てにくい | 件数×1件あたりトークンで見積もれる |
| 出力の受け手 | 人(誤りに気づける余地はあるが、見落としも起きる) | プログラム(表記の違いでも後段処理が止まる) |
| 品質の評価 | 印象になりがち | 正答率で採点できる |
14Bの合計生成速度13.3トークン/秒を、1件あたり生成300トークンとして単純換算すると、1時間に約160件、8時間で約1,300件です。入力の処理、検証、再試行、障害停止の時間は含まないため、本番の処理能力には余裕を持たせます。
どこにローカルLLMを差し込み、どこに人を残すか
3章の実測をそのまま使って、2つのワークフローを組み立ててみます。
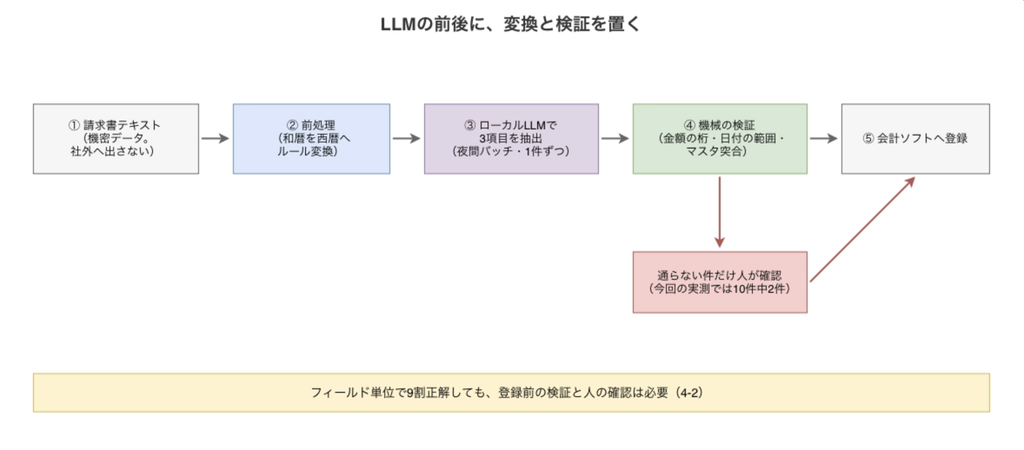
請求書処理の例: 受信した請求書のテキストから3項目を抜き出す工程にローカルLLMを置きます。画像やPDFをテキスト化する前段については「【脱・OCR】Dify×VLMで、あらゆる画像・PDFを思い通りのJSONに変換する」もご参考ください。今回の10件では、1.7Bでもフィールド単位で27/30でしたが、3項目の完全一致は8/10でした。そのまま登録すれば2件はどこかの項目が誤っています。金額の桁、日付の範囲、取引先マスタを機械で照合し、通らないものだけ人が確認します。和暦はLLMへ渡す前にルールで西暦へ変換した方が、モデルを大きくするより挙動を管理しやすくなります。
問い合わせ振り分けの例: 分類は1.7Bで3/10、4Bで6/10、14Bで8/10でした。この3候補だけなら14Bが残りますが、系統が異なるため「14B以上なら足りる」とは言えません。まずカテゴリの定義と具体例をプロンプトに加え、迷う入力には「保留」を許します。出力が4つのカテゴリ名と一致しない場合も保留へ回します。「総务」のように意味が合っていても文字列が違えば、後段処理は正しく動きません。出力の検証まで含めて1つの工程です。
小規模言語モデルの業務活用では、汎用的な受け答えを期待するより、入力と出力を限定した方が評価しやすくなります。精度が足りなければ、すぐにモデルを大きくするのではなく、定義文、具体例、前処理、保留条件の順に見直します。業務データを使った微調整(追加学習)は、その後の選択肢です。学習データの作成と、業務変更のたびに評価し直す運用まで含めて判断します。
損益分岐は月額どうしをそろえて計算する
オンプレLLMの費用対効果を見るとき、機材の購入額とAPIの月額を直接比べても損益分岐は出ません。入力と出力の単価を分け、ローカル側の月次運用費も含めます。
- 月間の入力・出力トークン数 = 1件あたりの入力・出力トークン数 × 月間件数
- APIの月額 = 入力トークン数 × 入力単価 + 出力トークン数 × 出力単価(単価が100万トークンあたりなら、それぞれ100万で割って計算)
- ローカルの月次運用費 = 電力 + 保守・監視の人件費 + 周辺設備やソフトウェアの費用
- 損益分岐までの月数 = 機材などの初期費用 ÷(APIの月額 − ローカルの月次運用費)
APIの月額がローカルの月次運用費以下なら、費用面の損益分岐は来ません。また、同じ100万トークンでも入力と出力の比率によってAPI費用は変わります。
1-1の費用便益分析は、人件費と保守費を除いた範囲で、小型モデルが0.3〜2.5ヶ月、大型が最長69.3ヶ月という損益分岐を示しています。別のGPU実測研究では、短い応答を自社で生成する電力費は100万トークンあたり0.001〜0.005ドルでした。電力単価は0.12ドル/kWhです。1日3,000万トークンを処理する前提では、損益分岐がGPT-5 nano比で292日、Claude Opus 4.5比で4日でした。処理量が少なければ、その期間は比例して延びると記されています。
比較先が高価格帯のAPIなら早く、低価格帯なら遅く損益分岐へ達します。たとえば月120万トークンの小さな処理なら、同研究が置いた最安帯APIの混合単価では月1ドル未満です(入力と出力を同量とみなし、Gemini 2.0 Flash-Liteは100万トークンあたり0.19ドル、GPT-5 nanoは0.23ドル)。この規模では、費用だけを理由にローカル化するのは難しいでしょう。機密データの取り扱い方針や、外部サービス停止時にも処理を続ける必要があるか、といった非金銭面を別に評価します。
補足: 2つの研究とも費用の範囲に限定があります。費用便益分析は人件費・保守費を含まず、GPU実測研究の電力はGPU分のみでCPUと冷却が別途20〜40%かかると明記されています。稟議に使う場合はこの2行を必ず添えてください。
任せてよい業務の線引き
実測と論文をまとめると、この規模帯の線引きは次のようになります。
| 業務の型 | 例 | 実測からの目安 |
|---|---|---|
| 値を写す抽出 | 請求書・帳票からの項目抜き出し | 今回は1.7Bでも27/30。形式・数値・マスタを検証し、外れた件は人へ回す |
| 選択肢からの分類 | 問い合わせの振り分け、タグ付け | 1.7Bは全問同じカテゴリ。定義文と保留を加え、同一系統の候補でも比較する。Qwen系はQ8_0も試す |
| 型のある変換 | 和暦の日付、表記の正規化 | LLMに任せずルールで前処理する |
| 自由記述の要約 | 議事録・報告書の要約 | 自動採点しにくい。根拠文との照合を残し、人が確認する |
| 高度な推論・重要判断 | 契約リスクの判断、金額の承認 | モデルだけに任せず、人が根拠を確認して最終判断する |
今回の機材とOllama既定設定では、汎用チャットより、機密データを扱う定型処理の方が組み込みやすいと分かりました。キューで処理量を平準化でき、入力と正解を用意できるためです。ローカルで動かすだけで安全になるわけではないので、APIの到達範囲、利用者の権限、ログ、モデルのライセンスと更新方法も別途決めます。
まとめと結論
- パラメータ数だけでは企業運用を決められません。 14Bは読み込み済みなら短い要約を4.4秒で返しましたが、Ollamaの既定設定で4件同時に送ると全件完了まで17.7秒かかりました。品質も、1.7Bが抽出で27/30だった一方、分類では10問すべてに同じカテゴリを返しています
- 費用は利用量と比較先で結論が変わります。 論文の0.3〜2.5ヶ月という損益分岐は、24〜32Bのモデルを月8,600万トークン以上動かす想定です。月100万トークン程度なら、機密性や継続性を費用とは分けて判断します
- 最初は、誤りを機械で検出できる業務に絞ります。 前処理、出力検証、保留、人の確認を組み合わせ、自社データで誤り方を見てから範囲を広げます。今回の10問は候補を落とす試験であり、モデルの順位を確定するものではありません
導入前チェックリスト
自社でローカルLLMのワークフロー化を始められるかを判断するための項目です。作業の完了確認ではなく、着手できるかどうかの材料として使ってください。
- 対象業務を、チャット型か定型ワークフロー型かで仕分けた
- 1件あたりトークン数と月間件数から、月間処理量を見積もった
- 利用予定のAPI単価と機材・電力費で損益分岐を計算した(人件費・保守費は別枠と明記した)
- 業務データから採点できるテストを作り、候補モデルを同じ設定で複数回通した(10問はふるい、本番比較は100問程度から)
- 和暦・固有名詞・レイアウト崩れなど、日本語特有の入力をテストに混ぜた
- 出力の検証(形式・数値範囲・カテゴリ名の完全一致)と、通らない件を人へ回す経路を設計した
- 同時に使う人数のピークを見積もり、待ち時間を実測した
- 使用モデルと量子化の版を記録し、差し替えるときは同じテストを通す運用を決めた
- APIの到達範囲、利用者の権限、ログの保管先、障害時の停止方法を決めた
- モデルと周辺ソフトウェアのライセンス、更新手順、担当者を確認した
検証環境:
- macOS 26.5.2、Apple M5、メモリ24GB(外付けGPUなしの単体Mac)
- Ollama 0.32.5、Python 3.14.7(スクリプトは標準ライブラリのみ使用)
- モデル: qwen3:1.7b(ID
8f68893c685c、表記2.0Bパラメータ)、qwen3:4b-instruct(ID0edcdef34593、4.0B)、qwen2.5:14b(ID7cdf5a0187d5、14.8B)。いずれもQ4_K_M量子化 - 検証日: 2026年9月3日
- 速度は3回実行の実測値、品質は温度0での1回実行の採点結果です。モデルの版やOllamaのバージョンが変わると結果も変わります
- 同時アクセスの測定は、Ollamaの初期設定(同時処理数を変更しない状態)で行いました
- 費用の引用はドル表記のままにしています。円換算する場合は換算日とレートを明記してください
- 各ツールの最新の仕様は公式ドキュメントで確認してください
付録|スクリプト全文
本文で抜粋したスクリプト2本の全文です。Pythonの標準ライブラリだけで動くため、追加のインストールは不要です。Ollamaが起動した状態で python3 bench_speed.py のように実行してください。モデル名の一覧(MODELS)を書き換えれば、任意のモデルで同じ表が出せます。
bench_speed.py(2章:速度と同時アクセス)
import json                          # APIの入出力と結果の整形
import time                          # 実時間の計測
import urllib.request                # Ollamaへの HTTP リクエスト(標準ライブラリのみ)
import threading                     # 同時アクセスの再現

URL = "http://localhost:11434/api/generate"        # OllamaのローカルAPI
MODELS = ["qwen3:1.7b", "qwen3:4b-instruct", "qwen2.5:14b"]   # 小・中・大の3段階
THINKING = {"qwen3:1.7b"}            # 思考モードを持つモデル。比較条件をそろえるため無効化する

# 社内文書を模した固定の日本語プロンプト。全モデル・全試行で同一
PROMPT = (
    "次の議事録を、決定事項と宿題に分けて3行以内で要約してください。\n"
    "議事録:本日の定例では、月次売上の報告のあと、新しい問い合わせ管理ツールの導入可否を議論した。"
    "営業部からは現行の共有シートで漏れが月3件発生しているとの報告があった。"
    "情報システム部が来週までに候補ツール2つの費用を見積もる。"
    "導入判断は次回定例で行う。研修の日程は総務部が今月中に調整する。"
)

def generate(model, num_predict=200):
    """1回生成し、Ollamaが返す計測値(ナノ秒)を取り出す"""
    body = {"model": model, "prompt": PROMPT, "stream": False,
            "options": {"temperature": 0, "num_predict": num_predict}}
    if model in THINKING:
        body["think"] = False                      # 思考の出力を止めて条件をそろえる
    req = urllib.request.Request(URL, json.dumps(body).encode(),
                                 {"Content-Type": "application/json"})
    t0 = time.time()
    r = json.load(urllib.request.urlopen(req, timeout=1200))
    r["wall"] = time.time() - t0                   # 依頼から完了までの実時間(秒)
    return r

def mem_gb(model):
    """メモリに読み込まれたサイズをGBで返す。見つからなければ例外にして黙って0を返さない"""
    ps = json.load(urllib.request.urlopen("http://localhost:11434/api/ps", timeout=30))
    loaded = {m["name"]: m["size"] for m in ps.get("models", [])}
    for name in (model, model + ":latest"):         # 版指定の有無どちらでも拾う
        if name in loaded:
            return loaded[name] / 1024**3
    raise RuntimeError("%s が読み込み済みモデルに見つかりません(%s)" % (model, list(loaded)))

print("=== 単独アクセスの速度(1回目は読み込み込み、2・3回目は読み込み済み) ===")
for model in MODELS:
    for i in range(3):
        r = generate(model)
        tps = r["eval_count"] / r["eval_duration"] * 1e9          # 生成速度(トークン/秒)
        ttft = (r.get("load_duration", 0) + r.get("prompt_eval_duration", 0)) / 1e9  # 1文字目までの待ち
        print("%-18s %d回目  生成 %5.1f tok/s  1文字目まで %5.2f 秒  合計 %5.1f 秒  生成 %3d tok"
              % (model, i + 1, tps, ttft, r["wall"], r["eval_count"]))
    print("%-18s メモリ使用 %.1f GB" % (model, mem_gb(model)))

print("\n=== 同時アクセス(同じ依頼を1・2・4件同時に投げる) ===")
def bench_parallel(model, n):
    results = [None] * n
    errors = []
    def worker(k):
        try:
            results[k] = generate(model)
        except Exception as e:                     # 1件でも落ちたら測定値は使えない
            errors.append((k, e))
    generate(model, num_predict=8)                 # 読み込みを済ませてから測る
    t0 = time.time()
    threads = [threading.Thread(target=worker, args=(k,)) for k in range(n)]
    for t in threads: t.start()
    for t in threads: t.join()
    total = time.time() - t0
    if errors:                                     # 欠けたまま平均を出すと数字が良く見える
        raise RuntimeError("同時%d件のうち%d件が失敗: %s" % (n, len(errors), errors[0][1]))
    toks = sum(r["eval_count"] for r in results)
    walls = sorted(r["wall"] for r in results)
    print("%-18s 同時%d件  全件完了 %5.1f 秒  合計 %5.1f tok/s  最も待った人 %5.1f 秒"
          % (model, n, total, toks / total, walls[-1]))

for model in ["qwen3:4b-instruct", "qwen2.5:14b"]:
    for n in [1, 2, 4]:
        bench_parallel(model, n)
bench_quality.py(3章:抽出と分類の採点)
import json                          # APIの入出力とJSONの照合
import re                            # 応答からJSON部分を取り出す
import urllib.request                # Ollamaへの HTTP リクエスト(標準ライブラリのみ)

URL = "http://localhost:11434/api/generate"
MODELS = ["qwen3:1.7b", "qwen3:4b-instruct", "qwen2.5:14b"]
THINKING = {"qwen3:1.7b"}

def ask(model, prompt, num_predict):
    """温度0で1回生成し、応答本文を返す"""
    body = {"model": model, "prompt": prompt, "stream": False,
            "options": {"temperature": 0, "num_predict": num_predict}}
    if model in THINKING:
        body["think"] = False
    req = urllib.request.Request(URL, json.dumps(body).encode(),
                                 {"Content-Type": "application/json"})
    return json.load(urllib.request.urlopen(req, timeout=1200))["response"]

# ---- 課題1:請求書テキストからの抽出(10問、正解はフィールド単位で30個) ----
EXTRACT = [
 ("株式会社山田製作所より2026年7月31日付でご請求申し上げます。合計金額は330,000円(税込)です。",
  {"company": "株式会社山田製作所", "date": "2026-07-31", "amount": 330000}),
 ("請求日:令和8年8月15日 有限会社ミドリ物流 お支払金額 ¥1,254,800-",
  {"company": "有限会社ミドリ物流", "date": "2026-08-15", "amount": 1254800}),
 ("2026/08/01 テック商事株式会社 御請求額 98,000円 なお前回未払分12,000円は含みません。",
  {"company": "テック商事株式会社", "date": "2026-08-01", "amount": 98000}),
 ("合同会社さくらデザインからの請求書。発行日は二〇二六年六月三十日、金額は五十五万円。",
  {"company": "合同会社さくらデザイン", "date": "2026-06-30", "amount": 550000}),
 ("INVOICE  Kito Trading Co., Ltd.  Date: 31 May 2026  Total: JPY 462,000",
  {"company": "Kito Trading Co., Ltd.", "date": "2026-05-31", "amount": 462000}),
 ("株式会社北村電機 2026年8月10日発行 小計200,000円 消費税20,000円 合計220,000円",
  {"company": "株式会社北村電機", "date": "2026-08-10", "amount": 220000}),
 ("カワイ印刷株式会社、令和8年7月1日、税抜金額 90,909円、税込 100,000円。ご請求は税込額です。",
  {"company": "カワイ印刷株式会社", "date": "2026-07-01", "amount": 100000}),
 ("フジ建設株式会社 請求書(2026.6.15)ご請求金額:3,080,000円(値引き220,000円適用後)",
  {"company": "フジ建設株式会社", "date": "2026-06-15", "amount": 3080000}),
 ("請求元:株式会社アオイ食品/請求日:2026年08月20日/今月のご請求:74,800円/来月請求予定:81,000円",
  {"company": "株式会社アオイ食品", "date": "2026-08-20", "amount": 74800}),
 ("有限会社ホシノ工業の請求内容。日付 2026-07-05。合計 ¥58,300(振込手数料は貴社負担)",
  {"company": "有限会社ホシノ工業", "date": "2026-07-05", "amount": 58300}),
]
EX_PROMPT = ("次の文から会社名・請求日・請求金額を抜き出し、JSONだけを出力してください。"
             "キーは company・date・amount。dateはYYYY-MM-DD形式、amountは数値のみ。\n文:%s")

def parse_json(text):
    """応答の中から最初のJSONオブジェクトを取り出す(波かっこの対応を数えて閉じ位置を決める)"""
    text = re.sub(r"```(?:json)?", "", text)       # コードフェンスがあれば外す
    start = text.find("{")
    if start < 0:
        return {}
    depth = 0
    for i, ch in enumerate(text[start:], start):   # 入れ子のJSONでも末尾を取り違えない
        depth += (ch == "{") - (ch == "}")
        if depth == 0:
            try:
                return json.loads(text[start:i + 1])
            except Exception:
                return {}
    return {}                                      # 閉じかっこが来ない=生成の打ち切り

def norm_amount(v):
    """金額の表記ゆれ(カンマ・円・文字列)を数値へそろえる"""
    if isinstance(v, (int, float)):
        return int(v)
    digits = re.sub(r"[^0-9]", "", str(v))
    return int(digits) if digits else None

# ---- 課題2:社内問い合わせの振り分け(10問) ----
CLASSIFY = [
 ("先月の交通費精算がまだ振り込まれていません", "経理"),
 ("ノートPCの画面が映らなくなりました。代替機はありますか", "情シス"),
 ("有給休暇の残日数を確認したいです", "人事"),
 ("会議室のプロジェクターの電球が切れています", "総務"),
 ("請求書の宛名を変更して再発行してほしいと取引先から連絡がありました", "経理"),
 ("共有フォルダにアクセスできません。権限を付けてください", "情シス"),
 ("産休の申請手続きについて教えてください", "人事"),
 ("オフィスの空調が強すぎて寒いです", "総務"),
 ("新しい取引先を仕入先マスタに登録してほしい", "経理"),
 ("社用スマホを紛失しました。回線を止めてください", "情シス"),
]
CL_PROMPT = ("次の社内問い合わせを、経理・情シス・人事・総務のどれか1つに振り分けてください。"
             "カテゴリ名だけを出力してください。\n問い合わせ:%s")

for model in MODELS:
    field_ok = 0        # 抽出のフィールド正解数(30個満点)
    item_ok = 0         # 抽出の3フィールド完全一致数(10問満点)
    miss = []
    for text, gold in EXTRACT:
        got = parse_json(ask(model, EX_PROMPT % text, 160))
        ok = {
            "company": str(got.get("company", "")).strip() == gold["company"],
            "date": str(got.get("date", "")).strip() == gold["date"],
            "amount": norm_amount(got.get("amount")) == gold["amount"],
        }
        field_ok += sum(ok.values())
        item_ok += all(ok.values())
        if not all(ok.values()):
            miss.append((gold["company"], {k: got.get(k) for k, v in ok.items() if not v}))
    cls_ok = 0          # 分類の正解数(10問満点)
    cls_miss = []
    for text, gold in CLASSIFY:
        ans = ask(model, CL_PROMPT % text, 16).strip()
        if ans == gold:
            cls_ok += 1
        else:
            cls_miss.append((text[:16], gold, ans[:20]))
    print("%-18s 抽出: フィールド %2d/30  3項目全部一致 %2d/10   分類: %2d/10"
          % (model, field_ok, item_ok, cls_ok))
    for m_ in miss:
        print("    抽出の誤り %s -> %s" % m_)
    for m_ in cls_miss:
        print("    分類の誤り %s… 正解=%s 出力=%s" % m_)
最後に
私たちは、単にシステムを組むだけの開発会社ではありません。低コストで高品質なAIツールの構築から、ROI(投資対効果)を最大化する導入ロードマップの策定、社内スタッフが自らAIを運用・改善できる体制の構築まで、AI導入の成功に必要なすべてを最初から最後まで丸ごと支援いたします。
実は、ご相談いただく方のほとんどが「何が分からないかも分からない」という状態からのスタートです。構想段階でも、ただのアイデアベースでも構いません。
まずは、あなたのお困りごとをそのまま聞かせていただけませんか?貴社のビジネスを加速させるパートナーとして伴走いたします。
無料オンライン相談で、最適な導入プランを相談する
参考文献
- Guanzhong Pan、Vishal Chodnekar、Abinas Roy、Haibo Wang「A Cost-Benefit Analysis of On-Premise Large Language Model Deployment: Breaking Even with Commercial LLM Services」(v3・2025年11月11日改訂版を参照、2026年9月3日参照)
- Kelly Marchisio、Saurabh Dash、Hongyu Chen、Dennis Aumiller、Ahmet Üstün、Sara Hooker、Sebastian Ruder「How Does Quantization Affect Multilingual LLMs?」(Findings of EMNLP 2024、2026年9月3日参照)
- Jonathan Knoop、Hendrik Holtmann「Private LLM Inference on Consumer Blackwell GPUs: A Practical Guide for Cost-Effective Local Deployment in SMEs」(2026年9月3日参照)
- Takato Yasuno「Adapting Methods for Domain-Specific Japanese Small LMs: Scale, Architecture, and Quantization」(2026年9月3日参照)
- Ollama「公式ドキュメント(FAQ)」(2026年9月3日参照)